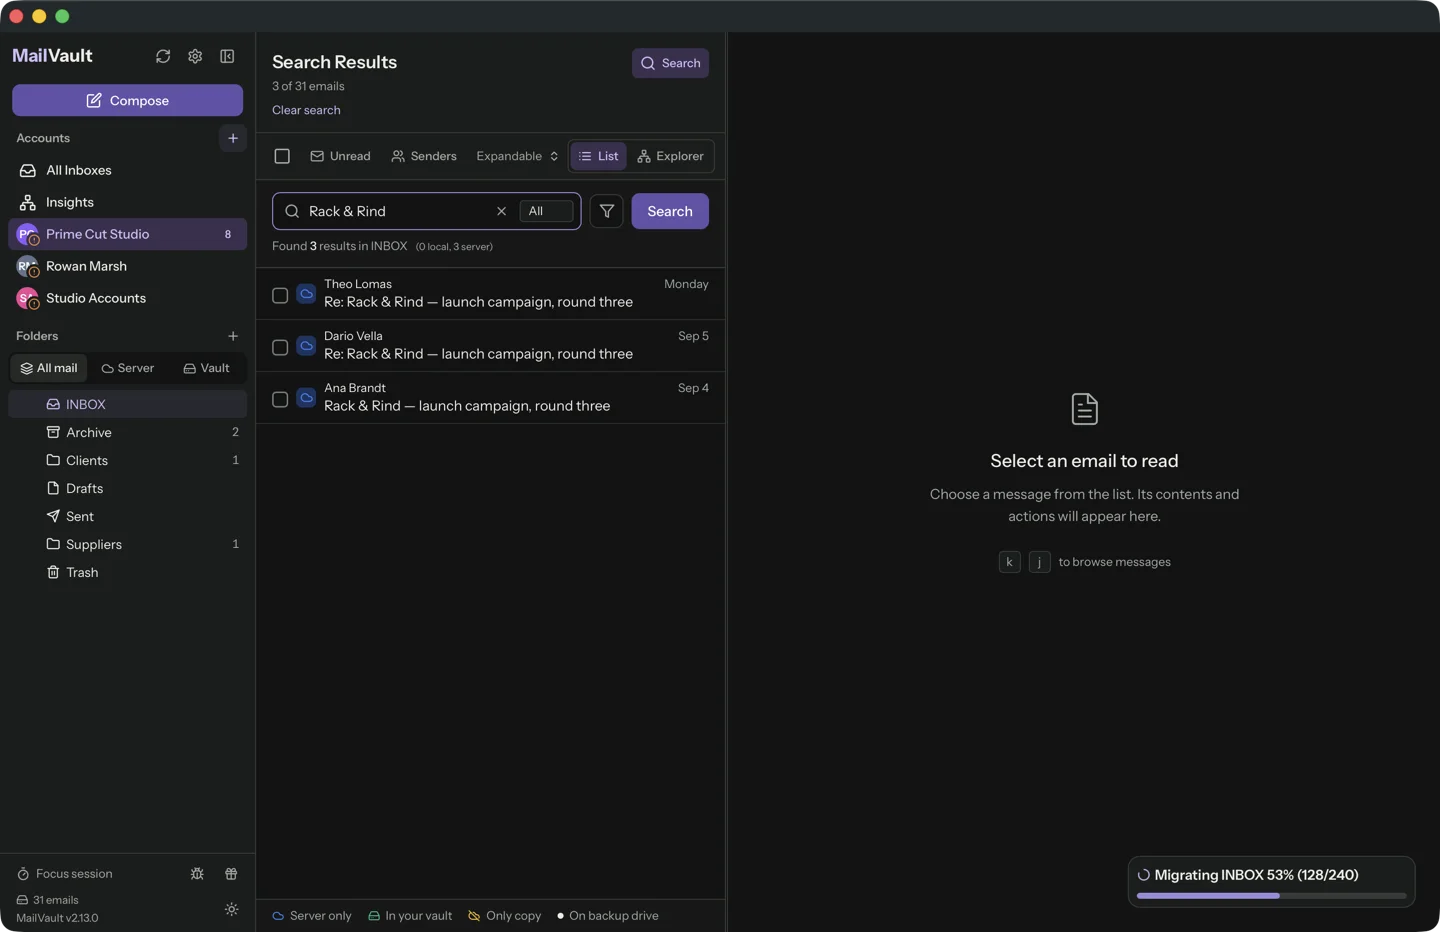
Die meisten Mail-Clients behandeln die Suche als Funktion. Wir behandeln sie als Latenzbudget. Der ganze Grund, warum MailVault existiert, ist, dass Sie Jahrzehnte an Mail auf Ihrer eigenen Festplatte halten, und ein Archiv, das sich nicht in weniger als einem Herzschlag durchsuchen lässt, ist eine Müllhalde.
Also haben wir einen Vault mit 50.000 Nachrichten gebaut und ihn gemessen. Die langsamste Abfrage brauchte 14 Millisekunden. Interessant ist, was es dafür brauchte, und das Release, in dem wir sie um das 30-Fache langsamer gemacht haben, ohne es zu merken.
Die Zahlen
Eine Maschine, fünf Abfrageformen, je sechs Läufe (drei auf einem Scratch-Build der Korrektur, drei auf dem gemergten Code). Die Zeiten umfassen die Suche plus den Aufbau der Zeilen, die die Liste zeichnet:
MailVault daemon · release build · Apple M4, 16 GB · warm cache
50,000 synthetic messages, avg 3,334 bytes, 3 folders

query                    matches   rows    time (6 runs)
invoice                  ~2,500    500     7.1 – 7.5 ms
budget meeting           246       246     13.4 – 14.1 ms
update 4999              15        15      13.5 – 14.0 ms
会議                    1,529     500     4.3 – 4.6 ms
last 7 days, no words    1,008     500     1.0 ms

index build (cold)       50,000 msgs   10.9 – 11.9 s
index on disk            224,968,704 bytes
result-row parses        0
Der Korpus ist erzeugt, keine echte Mail: 200 Füllwörter pro Nachricht als Nur-Text und HTML, dazu zehn eingesetzte Wörter mit festen Anteilen (invoice 5 %, budget 8 %, meeting 6 %, darunter drei japanische und akzentuierte Begriffe), damit jede Abfrage eine bekannte Antwortgröße hat. Der Generator ist deterministisch, ein erneuter Lauf baut also dieselben 50.000 Dateien. Die Maschine wurde während der Tests mit anderen Builds geteilt, es ist also ein ausgelasteter Computer, kein Labor.
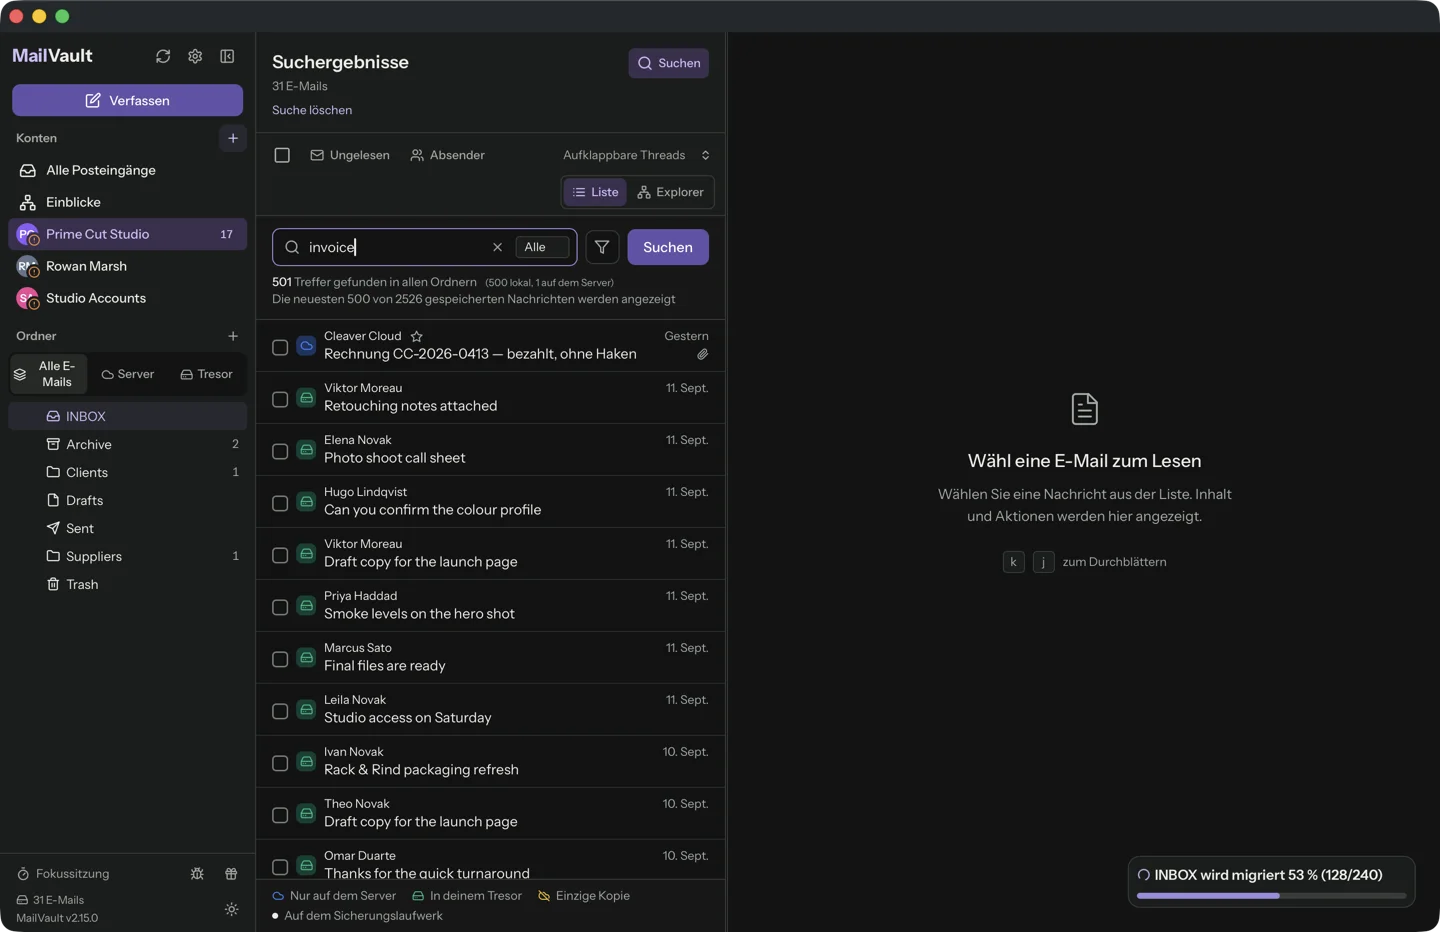
Zur Verdeutlichung der Größenordnung: Ein 60-Hz-Display zeichnet alle 16.7 ms neu, und jede Abfrage oben ist innerhalb eines Neuzeichnens fertig. Jakob Nielsens Antwortzeitgrenzen, seit 1993 unverändert, liegen bei 0.1 s für „sofort“, 1 s für ungestörtes Denken und 10 s für verlorene Aufmerksamkeit. Unsere langsamste Antwort ist ein Siebtel der ersten Grenze. Das Lineal unten ist logarithmisch, jeder Teilstrich ist das Zehnfache des vorherigen, und an seinem rechten Ende lebte die erste Version der Offline-Suche.
Selbst nachprüfen
Der Benchmark ist ein ignorierter Test im Quellbaum und bremst deshalb normale Läufe nie. Er baut den Korpus in einem temporären Verzeichnis, indexiert ihn mit dem echten MIME-Parser und gibt jede Zeile oben aus:
cargo test -p mailvault-daemon --release \
  search_index_bench_50k_real_parser -- --ignored --nocapture
Der Korpus wird kurz vor den Abfragen in ein frisches Verzeichnis geschrieben, der Seitencache ist also warm. Die erste Suche nach einem Neustart liest mehr von der Festplatte. Diesen Fall haben wir nicht gemessen und behaupten ihn nicht.
Warum eine schlichte SQL-Datenbank und keine Suchmaschine
Die Anforderungen waren unglamourös. Der Index muss im Vault liegen, weil sich der Vault auf ein externes Laufwerk oder einen NAS-Mount verschieben lässt. Er muss offline funktionieren. Er muss aus abgeleiteten Daten bestehen, die wir wegwerfen und neu aufbauen können. Und er darf keinen Dienst hinzufügen, den man starten, patchen oder einem Nutzer erklären muss.
Das ist SQLite mit seinem Volltextmodul FTS5. Eine Datei, von einem Prozess geöffnet, im Write-Ahead-Log-Modus mit exklusiver Sperre, gewählt, weil der Vault auf einer Netzwerkfreigabe liegen kann. Zwei virtuelle Tabellen tragen den Text:
- Eine Trigram-Tabelle für lateinischen Text. Jedes Wort wird als überlappende Drei-Buchstaben-Stücke gespeichert, und
voicfindetinvoice, ohne Platzhaltersyntax und ohne Ganzwortregel. Akzente werden vereinheitlicht, undreunionfindetRéunion. Abfragen mit einem oder zwei Buchstaben sind kürzer als ein Trigram, daher fallen sie auf einen einfachen Teilstring-Abgleich auf Betreff und Absender zurück. - Eine zweite Tabelle für CJK. Japanisch und Chinesisch haben keine Leerzeichen, an denen man trennen könnte, und ihre Wörter bestehen oft aus zwei Zeichen, also weniger als ein Trigram, daher laufen sie durch einen Tokenizer, der sie in einzelne Zeichen zerlegt und diese als Phrase abgleicht. Ohne ihn findet eine Suche nach
会議nichts.
Beide Tabellen sind ohne eigenen Inhalt: Sie halten die Suchstrukturen und keine zweite Kopie Ihrer Mail, und das ist ein großer Teil des Grundes, warum 50.000 Nachrichten in 225 MB passen.
Die Suche öffnet nie eine Nachricht
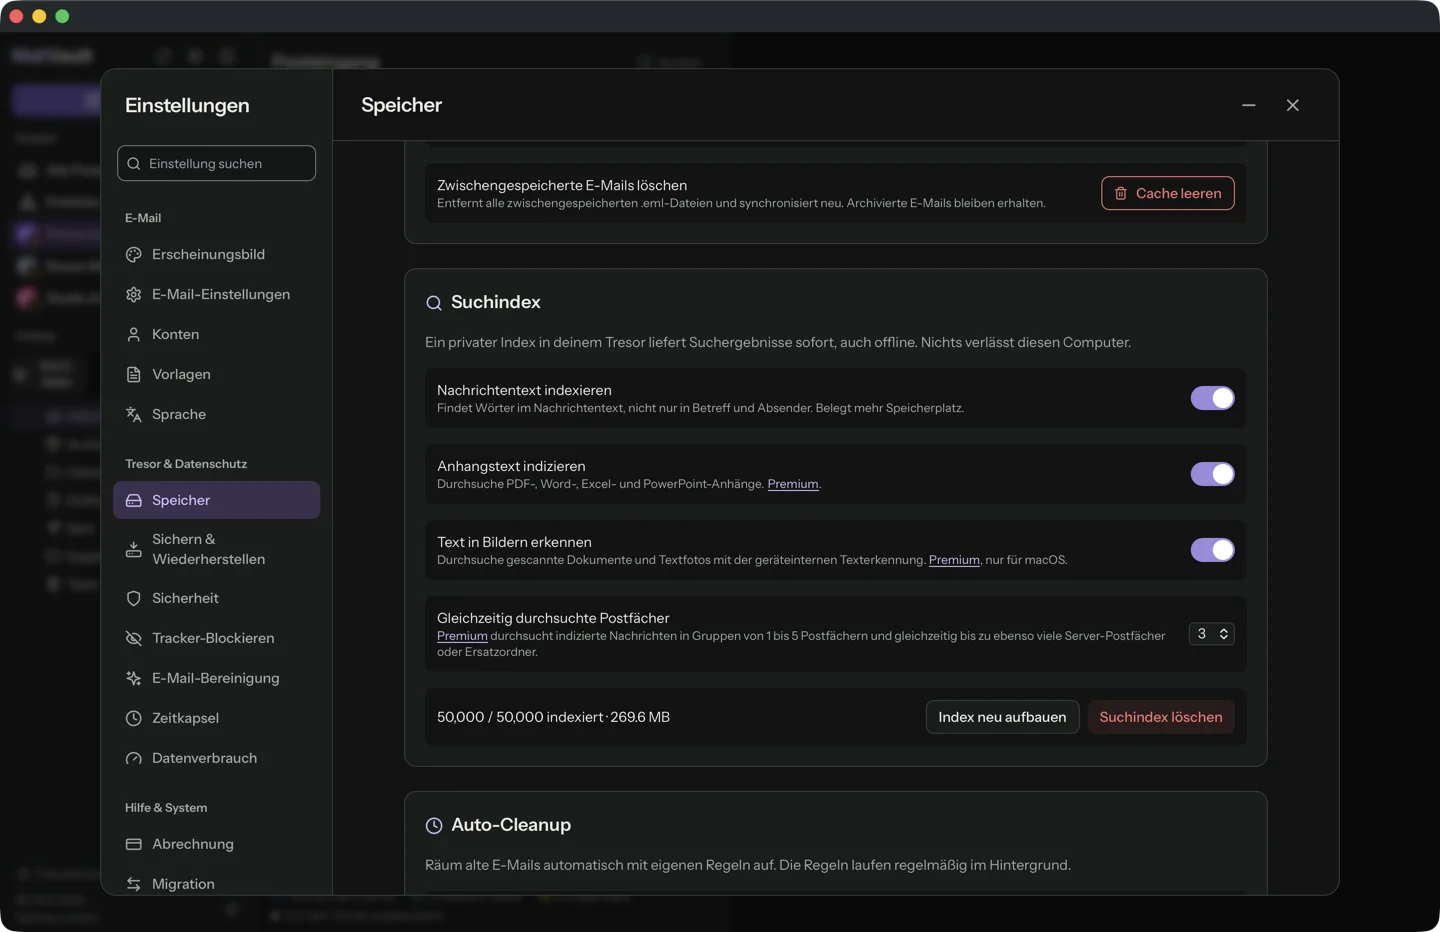
Die Liste braucht für jeden Treffer Absender, Betreff, Datum, Ordner und Flags. 500 Nachrichtendateien zu parsen, um sie zu bekommen, würde mehr kosten als die Abfrage. Deshalb speichert die Indexzeile die fertig gebaute Listenzeile, und aktuelle Flags werden am Dateinamen gelesen, wo das Maildir-Format sie ablegt. Der Benchmark zählt die Aufrufe des MIME-Parsers, während die Ergebnisse zusammengestellt werden, und die Antwort ist null.
Die Nachricht wird erst geöffnet, wenn Sie sie anklicken, und dann wird sie gegen die vom Index aufgezeichnete Message-ID geprüft, sodass eine von einem Server neu vergebene UID Ihnen nicht die falsche Mail anzeigen kann.
Den Index ehrlich halten
Ein Index, der vom Vault abweicht, ist schlimmer als keiner. Es gibt keine lange Kette von „beim Löschen auch den Index aktualisieren“-Hooks. Ein einziger Reconciler vergleicht die Ordnerauflistung (UID, Dateiname, Größe, Änderungszeit) mit dem, was der Index hält, und repariert die Differenz. Jeder Schreiber stößt ihn nur an. Ist die Datei beschädigt oder stammt sie aus einem neueren Schema, wird sie gelöscht und aus der Mail neu aufgebaut, und der Wiederherstellungscode entfernt ausschließlich die vier abgeleiteten Indexdateien. Nachrichten, Verwahrungsnachweise und Konten werden nie angefasst.
Was die erste Version stattdessen tat
Die erste Offline-Suche las Dateien. Bei jeder Suche wurde der Ordner aufgelistet, jede Nachricht per UID mit einem frischen Verzeichnisscan nachgeschlagen, geparst, jeder Text über die Prozessgrenze serialisiert und in JavaScript gefiltert. Ein Teil davon wurde gemessen: Ein Verzeichnisscan kostet bei einem Ordner mit 20.000 Nachrichten etwa 4.4 ms und lief einmal pro Nachricht, was sich für diesen Ordner allein auf etwa 88 Sekunden hochrechnet. Deshalb gibt es den Index, und deshalb ist eine Suche, die keine Dateien öffnet, die Entwurfsvorgabe und keine Optimierung.
Die Verlangsamung, die wir ausgeliefert haben
Bei der Vorbereitung der Zahlen für diese Notiz schlug der Benchmark fehl. Auf dem Code, der das Release 2.15.0 enthält, brauchte „invoice“ 221 ms, „budget meeting“ 500 ms, und die eigene 200-ms-Zusicherung des Tests schlug in allen drei Läufen an. Am 13. September hatte der Suchschritt derselben Abfrage 4 bis 7 ms gemessen.
Die Ursache war eine gute Funktion, die nachlässig hinzugefügt wurde. Um gefundene Begriffe im Reader hervorzuheben und Treffer zu markieren, die nur in einem Anhang gefunden wurden, bekam jede Ergebniszeile zwei Fragen: Passt der Text, passt der Anhangstext. Jede war als Unterabfrage geschrieben, die die Volltexttabelle zu jeweils einer Zeile befragt, und eine korrelierte Unterabfrage wie diese wird für jede Zeile, nach der gefragt wird, neu ausgeführt. Jeder Lauf durchläuft die Postings des Begriffs erneut, daher hängt der Preis von den Abfragebegriffen ab: Eine Phrase aus zwei Wörtern mit 246 Treffern (500 ms) war langsamer als ein einzelnes Wort mit etwa 2.500 (221 ms).
Die Korrektur ist eine Zeile an Form: den Index einmal nach der Menge der passenden Zeilen fragen und die Zugehörigkeit darin prüfen. Dieselben Ergebnisse, alle 18 bestehenden Abfragetests unverändert und ein neuer Schutztest, und die vier Werte sanken auf 7.4, 14.0, 14.0 und 4.5 ms. Die Lehre ist die langweilige. Das 200-ms-Gate gab es, und es war als ignoriert markiert, weil der Bau von 50.000 Nachrichten zwanzig Sekunden dauert. Ein Gate, das niemand ausführt, ist Dokumentation, deshalb wird die Korrektur mit einem Schutz ausgeliefert, der in normalen Testläufen läuft.
Anhänge und Vision, die Premium-Hälfte
Nachrichtentexte sind kostenlos. Anhangstext ist eine Premium-Option und hängt als eine weitere Spalte im selben Index, sodass eine Suche Nachrichten und die darin enthaltenen Dokumente zusammen trifft.
- Office-Dateien (Word, Excel, PowerPoint) sind ZIP-Archive aus XML und werden auf jeder Plattform in reinem Rust gelesen.
- PDFs nutzen die Textebene: PDFKit unter macOS, anderswo ein separater
pdf-extractProzess. - Bilder und gescannte PDFs laufen unter macOS über das Vision-Framework von Apple, auf dem Gerät, mit einer Obergrenze von 50 Seiten pro Dokument. Kleine Bilder (unter 10 KB oder 128 Pixel an der kurzen Seite) werden übersprungen, weil sie zu klein für lesbaren Text sind. Unter Windows und Linux gibt es keinen OCR-Schritt.
Die Grenzen sind Absicht: 25 MB pro Teil, 50 MB unkomprimiert bei einem Archiv, und eine nicht lesbare Datei wird zu einem festgehaltenen Zustand, nie zu einer Wiederholungsschleife. Ein vorübergehender Fehler wie ein E/A-Fehler wird beim nächsten Durchlauf wiederholt, und eine wirklich nicht unterstützte Datei wird markiert, damit sie nicht ewig versucht wird. Die Extraktion haben wir für diese Notiz nicht gemessen. Sie läuft einmal pro Anhang im Hintergrund, und ihre Kosten hängen von Ihren Dateien ab.
Was die anderen über ihre sagen
Wir haben keine davon gemessen, und keine veröffentlicht Zeiten bei 50.000 Nachrichten, es geht also um Konzepte und nicht um Stoppuhren. Apple sagt , die erste Indexierung von Spotlight könne Stunden oder sogar Tage dauern. Microsoft dokumentiert , dass die Suche des klassischen Outlook vom Windows-Search-Index abhängt, dass Ergebnisse unvollständig sein können, bis er fertig ist, und dass nur zwischengespeicherte Mail indexiert wird. Im Tracker von Thunderbird gibt es einen sechzehn Jahre alten Bericht über eine Verlangsamung der globalen Indexierung bei großen Postfächern, ein Nutzer nennt mehrere Tage für 36.000 Nachrichten auf einem Dual-Core-Rechner. Das ist anekdotisch und alte Hardware, und wir würden es nicht mit unserer vergleichen.
Was das nicht zeigt
Die Mail ist synthetisch und kurz, echte Nachrichten sind länger, und der Index wächst mit dem Nachrichtentext. Alles lief mit warmem Cache auf einem Mac. Die Suche in Anhängen wurde nicht gemessen. Mail, die nur auf dem Server liegt, ist gar nicht im Index: MailVault fragt den Server, listet lokale Treffer zuerst, und dieser Teil ist durch den Anbieter begrenzt, daher gibt es hier keine Zahl. Mit Premium werden bis zu fünf Server-Postfächer gleichzeitig durchsucht statt eines.
Fünfzigtausend E-Mails, ein Herzschlag. MailVault führt neben Ihrem Archiv einen privaten Suchindex: Nachrichtentexte kostenlos, Anhänge und Text in Bildern auf dem Gerät mit Premium.
MailVault herunterladen →