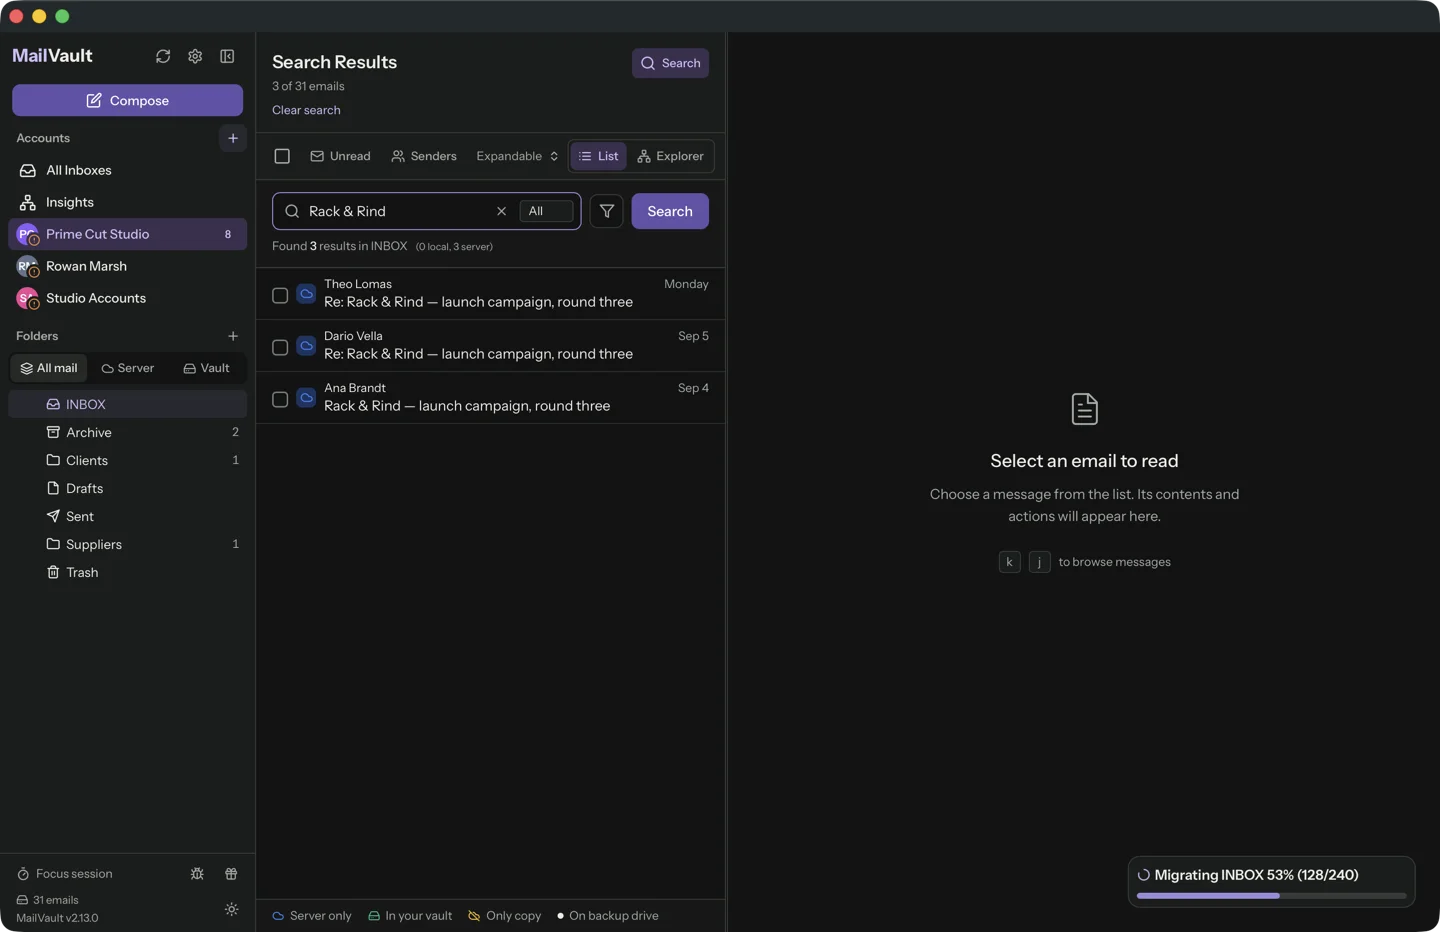
La plupart des clients de messagerie traitent la recherche comme une fonctionnalité. Nous la traitons comme un budget de latence. La raison d’être de MailVault est que vous gardez des décennies de courrier sur votre propre disque, et une archive que vous ne pouvez pas interroger en moins d’un battement de cœur est une décharge.
Nous avons donc construit un coffre de 50 000 messages et chronométré. La requête la plus lente a pris 14 millisecondes. Le plus intéressant est ce qu’il a fallu pour y arriver, et la version dans laquelle nous l’avons rendue 30 fois plus lente sans nous en apercevoir.
Les chiffres
Une machine, cinq formes de requête, six exécutions chacune (trois sur une version d’essai du correctif, trois sur le code fusionné). Les temps comprennent la recherche plus l’assemblage des lignes que dessine la liste :
MailVault daemon · release build · Apple M4, 16 GB · warm cache
50,000 synthetic messages, avg 3,334 bytes, 3 folders

query                    matches   rows    time (6 runs)
invoice                  ~2,500    500     7.1 – 7.5 ms
budget meeting           246       246     13.4 – 14.1 ms
update 4999              15        15      13.5 – 14.0 ms
会議                    1,529     500     4.3 – 4.6 ms
last 7 days, no words    1,008     500     1.0 ms

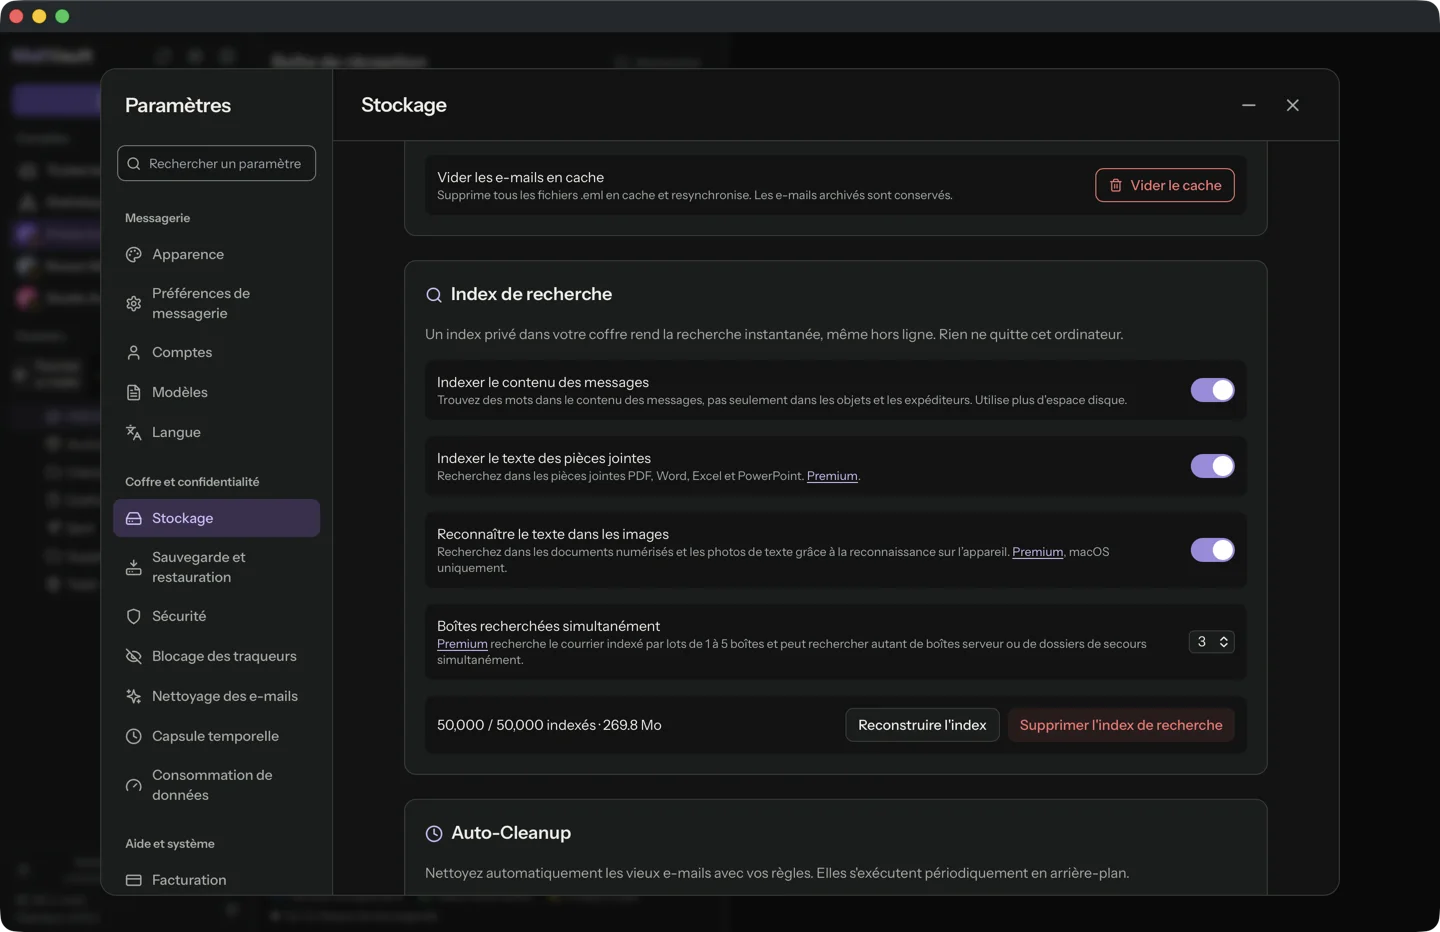
index build (cold)       50,000 msgs   10.9 – 11.9 s
index on disk            224,968,704 bytes
result-row parses        0
Le corpus est généré, pas du vrai courrier : 200 mots de remplissage par message en texte brut et en HTML, plus dix mots placés à des fréquences fixes (invoice 5 %, budget 8 %, meeting 6 %, dont trois termes japonais et accentués) pour que chaque requête ait une taille de réponse connue. Le générateur est déterministe, donc une nouvelle exécution reconstruit les mêmes 50 000 fichiers. La machine était partagée avec d’autres compilations pendant les tests ; c’est donc un ordinateur occupé, pas un laboratoire.
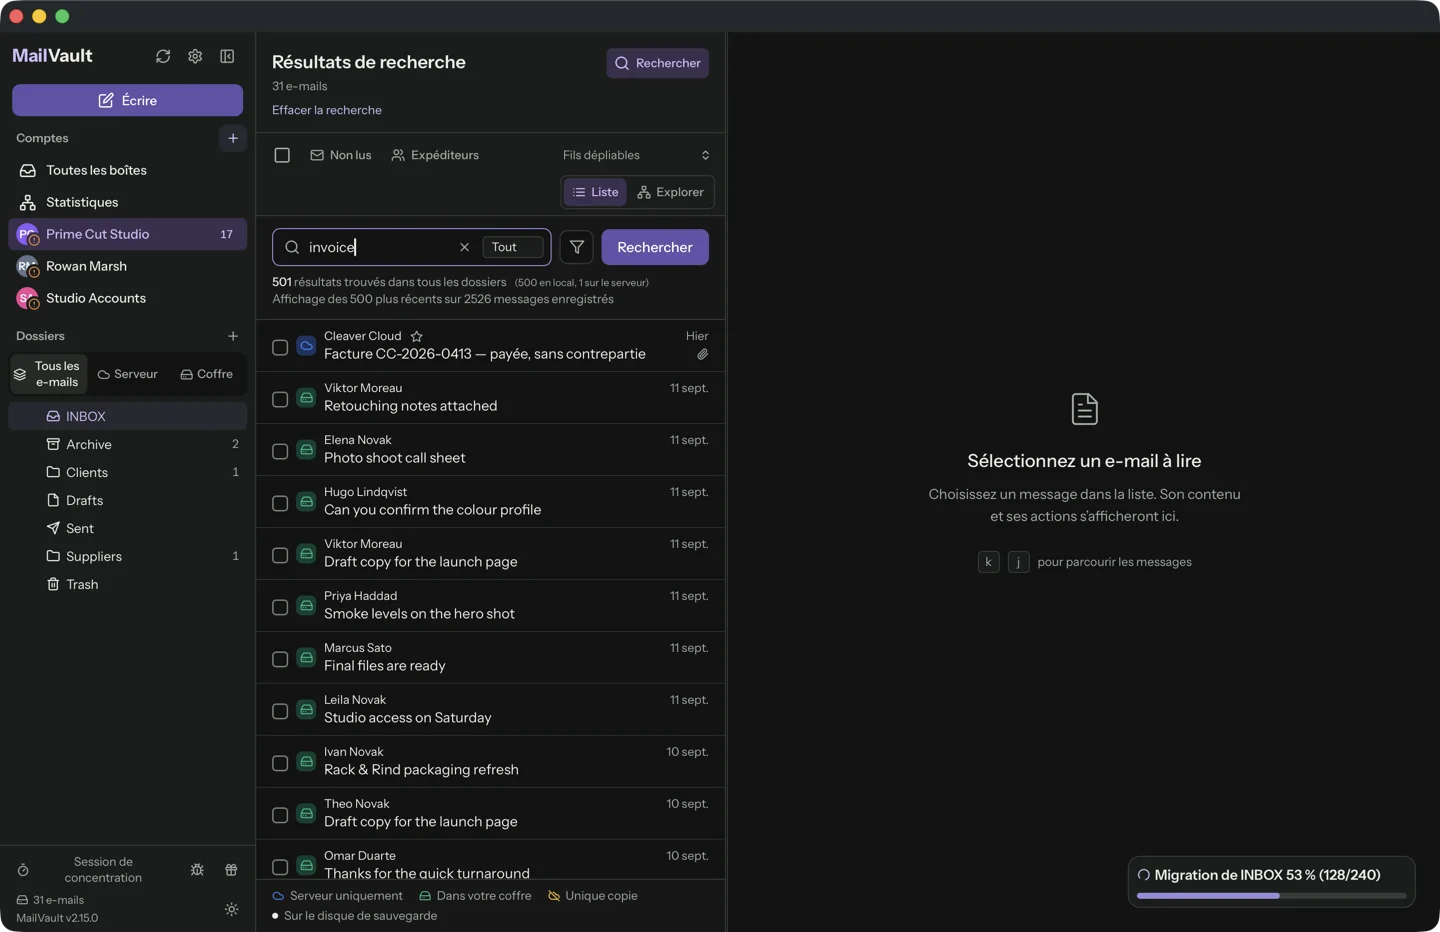
Pour donner l’échelle : un écran à 60 Hz se redessine toutes les 16.7 ms, et chaque requête ci-dessus se termine à l’intérieur d’un seul rafraîchissement. Les seuils de réponse de Jakob Nielsen, inchangés depuis 1993, sont de 0.1 s pour « instantané », 1 s pour une pensée ininterrompue et 10 s pour l’attention perdue. Notre réponse la plus lente représente un septième du premier seuil. La règle ci-dessous est logarithmique, chaque graduation valant dix fois la précédente, et son extrémité droite est là où vivait la première version de la recherche hors ligne.
Vérifiez par vous-même
Le benchmark est un test ignoré dans l’arborescence des sources, il ne ralentit donc jamais les exécutions ordinaires. Il construit le corpus dans un répertoire temporaire, l’indexe avec le véritable analyseur MIME et affiche chaque ligne ci-dessus :
cargo test -p mailvault-daemon --release \
  search_index_bench_50k_real_parser -- --ignored --nocapture
Le corpus est écrit dans un nouveau répertoire juste avant l’exécution des requêtes, le cache de pages est donc chaud. La première recherche après un redémarrage lit davantage sur le disque. Nous n’avons pas mesuré ce cas et ne prétendons rien à son sujet.
Pourquoi une base SQL simple, et non un moteur de recherche
Les exigences étaient peu glamour. L’index doit vivre à l’intérieur du coffre, car le coffre peut être déplacé vers un disque externe ou un montage NAS. Il doit fonctionner hors ligne. Il doit être une donnée dérivée que nous pouvons jeter et reconstruire. Et il ne doit pas ajouter un service à démarrer, à corriger ou à expliquer à un utilisateur.
C’est SQLite avec son module de recherche plein texte FTS5. Un seul fichier, ouvert par un seul processus, en mode write-ahead log avec un verrou exclusif, choix motivé par le fait que le coffre peut se trouver sur un partage réseau. Deux tables virtuelles portent le texte :
- Une table trigram pour le texte latin. Chaque mot est stocké sous forme de fragments de trois lettres qui se chevauchent, de sorte que
voictrouveinvoice, sans syntaxe de caractère générique ni règle de mot entier. Les signes diacritiques sont ignorés, de sorte quereuniontrouveRéunion. Les requêtes d’une ou deux lettres sont plus courtes qu’un trigram, elles se rabattent donc sur une correspondance de sous-chaîne simple sur l’objet et l’expéditeur. - Une seconde table pour le CJK. Le japonais et le chinois n’ont pas d’espaces pour découper le texte et leurs mots font souvent deux caractères, moins qu’un trigram ; ils passent donc par un tokenizer qui les découpe en caractères isolés et les recherche comme une expression. Sans lui, une recherche de
会議ne trouve rien.
Les deux tables sont sans contenu (contentless) : elles contiennent les structures de recherche et non une seconde copie de votre courrier, ce qui explique en grande partie pourquoi 50 000 messages tiennent dans 225 MB.
La recherche n’ouvre jamais un message
La liste a besoin de l’expéditeur, de l’objet, de la date, du dossier et des indicateurs pour chaque résultat. Analyser 500 fichiers de message pour les obtenir coûterait plus cher que la requête. La ligne de l’index stocke donc la ligne de liste déjà construite, et les indicateurs courants sont lus dans le nom de fichier, où le format maildir les conserve. Le benchmark compte les appels à l’analyseur MIME pendant l’assemblage des résultats, et la réponse est zéro.
Le message n’est ouvert que lorsque vous cliquez dessus, puis il est comparé au Message-ID enregistré par l’index, de sorte qu’un UID réattribué par un serveur ne puisse pas vous montrer le mauvais courrier.
Garder l’index fidèle
Un index qui dérive du coffre est pire que pas d’index. Il n’y a pas de longue chaîne de crochets « à la suppression, mettre aussi à jour l’index ». Un seul réconciliateur compare la liste du dossier (uid, nom de fichier, taille, date de modification) avec ce que contient l’index et répare l’écart. Chaque écrivain se contente de le solliciter. Si le fichier est endommagé ou provient d’un schéma plus récent, il est supprimé et reconstruit à partir du courrier, et le code de récupération ne supprime jamais que les quatre fichiers d’index dérivés. Les messages, les enregistrements de conservation et les comptes ne sont jamais touchés.
Ce que faisait la première version
La première recherche hors ligne lisait des fichiers. Chaque recherche listait le dossier, retrouvait chaque message par UID avec un nouveau balayage du répertoire, l’analysait, sérialisait chaque corps à travers la frontière du processus et filtrait en JavaScript. Nous avons mesuré une partie du coût : un nouveau balayage du répertoire coûte environ 4.4 ms sur un dossier de 20 000 messages, et il s’exécutait une fois par message, ce qui donne une projection d’environ 88 secondes pour ce seul dossier. C’est pourquoi l’index existe, et pourquoi une recherche qui n’ouvre aucun fichier est la contrainte de conception plutôt qu’une optimisation.
Le ralentissement que nous avons livré
En préparant les chiffres de cette note, le benchmark a échoué. Sur le code qui inclut la version 2.15.0, « invoice » a pris 221 ms, « budget meeting » 500 ms, et l’assertion de 200 ms du test s’est déclenchée aux trois exécutions. Le 13 septembre, l’étape de recherche de la même requête avait été mesurée à 4 à 7 ms.
La cause était une bonne fonctionnalité ajoutée sans soin. Pour surligner les termes trouvés dans le lecteur et pour marquer les résultats trouvés uniquement dans une pièce jointe, chaque ligne de résultat s’était vu poser deux questions : le corps correspond-il, le texte de la pièce jointe correspond-il. Chacune était écrite comme une sous-requête qui interroge la table plein texte pour une seule ligne à la fois, et une sous-requête corrélée de ce genre est réexécutée pour chaque ligne sur laquelle on l’interroge. Chaque exécution reparcourt les postings du terme, donc le prix dépend des termes de la requête : une expression de deux mots avec 246 résultats (500 ms) était plus lente qu’un mot seul avec environ 2 500 (221 ms).
Le correctif tient en une ligne de forme : interroger l’index une seule fois pour l’ensemble des lignes correspondantes et tester l’appartenance à cet ensemble. Mêmes résultats, les 18 tests de requête existants inchangés et un nouveau test de garde, et les quatre chiffres sont tombés à 7.4, 14.0, 14.0 et 4.5 ms. La leçon est la plus banale. Le seuil de 200 ms existait et était marqué ignoré, parce que construire 50 000 messages prend vingt secondes. Un seuil que personne n’exécute n’est que de la documentation, donc le correctif est livré avec une garde qui s’exécute dans les exécutions de test ordinaires.
Pièces jointes et Vision, la moitié Premium
Les corps sont gratuits. Le texte des pièces jointes est une option Premium, et il se branche dans le même index comme une colonne de plus, de sorte qu’une recherche touche ensemble les messages et les documents qu’ils contiennent.
- Fichiers Office (Word, Excel, PowerPoint) sont des archives zip de XML et sont lus en Rust pur sur toutes les plateformes.
- PDF utilisent la couche de texte : PDFKit sur macOS, un processus
pdf-extractdistinct ailleurs. - Images et PDF numérisés passent par le framework Vision d’Apple sur macOS, sur l’appareil, avec un plafond de 50 pages par document. Les petites images (moins de 10 KB ou 128 pixels sur le petit côté) sont ignorées car trop petites pour contenir du texte lisible. Windows et Linux n’ont pas d’étape OCR.
Les limites sont voulues : 25 MB par partie, 50 MB décompressés pour une archive, et un fichier illisible devient un état enregistré, jamais une boucle de nouvelles tentatives. Un échec transitoire comme une erreur d’E/S est retenté au balayage suivant, et un fichier réellement non pris en charge est marqué pour ne pas être réessayé indéfiniment. Nous n’avons pas chronométré l’extraction pour cette note. Elle s’exécute une fois par pièce jointe en arrière-plan, et son coût dépend de vos fichiers.
Ce que disent les autres de la leur
Nous n’en avons évalué aucun, et aucun ne publie de temps à 50 000 messages ; ce sont donc des conceptions et non des chronomètres. Apple indique que la première indexation de Spotlight peut prendre des heures, voire des jours. Microsoft précise que la recherche d’Outlook classique dépend de l’index Windows Search, que les résultats peuvent être incomplets tant qu’il n’est pas terminé, et que seul le courrier en cache est indexé. Le gestionnaire de bogues de Thunderbird contient un signalement vieux de seize ans concernant le ralentissement de l’indexation globale sur de grandes boîtes aux lettres, un utilisateur citant plusieurs jours pour 36 000 messages sur une machine à double cœur. C’est anecdotique et sur du matériel ancien, et nous ne le comparerions pas au nôtre.
Ce que cela ne montre pas
Le courrier est synthétique et court, le vrai courrier est plus long et l’index grossit avec le texte des corps. Tout a été mesuré à cache chaud sur un seul Mac. La recherche dans les pièces jointes n’a pas été chronométrée. Le courrier qui n’existe que sur le serveur n’est pas du tout dans l’index : MailVault interroge le serveur, liste d’abord les résultats locaux, et cette partie est bornée par le fournisseur, elle n’a donc pas de chiffre ici. Premium recherche jusqu’à cinq boîtes serveur à la fois au lieu d’une.
Cinquante mille e-mails, un battement de cœur. MailVault conserve un index de recherche privé à côté de votre archive : les corps gratuitement, les pièces jointes et le texte des images sur l’appareil avec Premium.
Obtenir MailVault →