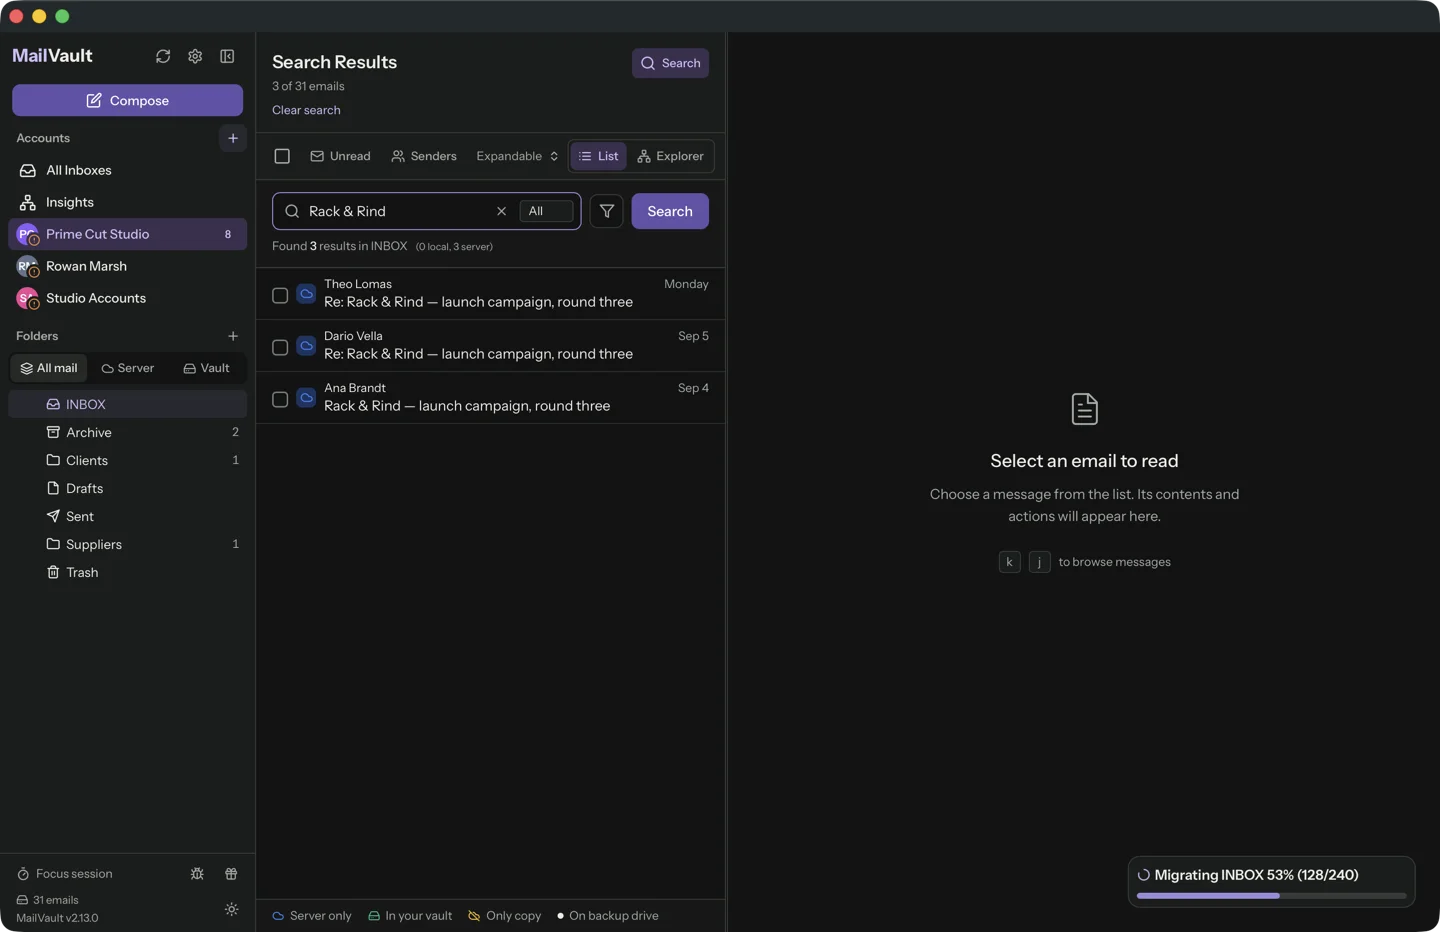
대부분의 메일 클라이언트는 검색을 하나의 기능으로 취급합니다. 우리는 지연 시간 예산으로 취급합니다. MailVault가 존재하는 이유는 수십 년치 메일을 자기 디스크에 보관하는 데 있고, 눈 깜짝할 사이에 검색할 수 없는 아카이브는 쓰레기 매립지일 뿐입니다.
그래서 메시지 50,000개짜리 볼트를 만들어 시간을 쟀습니다. 가장 느린 쿼리는 14밀리초가 걸렸습니다. 흥미로운 부분은 거기까지 가는 데 든 일과, 우리가 알아채지 못한 채 30배 느리게 만들었던 그 릴리스입니다.
숫자
기기 한 대, 쿼리 형태 다섯 가지, 각 6회 실행(수정본의 임시 빌드에서 3회, 병합된 코드에서 3회). 시간은 검색과 목록이 그리는 행을 조립하는 시간을 합한 값입니다.
MailVault daemon · release build · Apple M4, 16 GB · warm cache
50,000 synthetic messages, avg 3,334 bytes, 3 folders

query                    matches   rows    time (6 runs)
invoice                  ~2,500    500     7.1 – 7.5 ms
budget meeting           246       246     13.4 – 14.1 ms
update 4999              15        15      13.5 – 14.0 ms
会議                    1,529     500     4.3 – 4.6 ms
last 7 days, no words    1,008     500     1.0 ms

index build (cold)       50,000 msgs   10.9 – 11.9 s
index on disk            224,968,704 bytes
result-row parses        0
코퍼스는 실제 메일이 아니라 생성한 것입니다. 메시지마다 일반 텍스트와 HTML로 된 채움 단어 200개, 그리고 고정 비율로 심은 단어 열 개(invoice 5%, budget 8%, meeting 6%, 그중 일본어와 악센트가 있는 단어 세 개 포함)를 넣어서 모든 쿼리의 정답 크기를 알 수 있습니다. 생성기는 결정적이므로 다시 실행하면 같은 파일 50,000개가 만들어집니다. 테스트 중에 다른 빌드가 함께 돌아갔으므로, 이것은 실험실이 아니라 바쁜 컴퓨터의 값입니다.
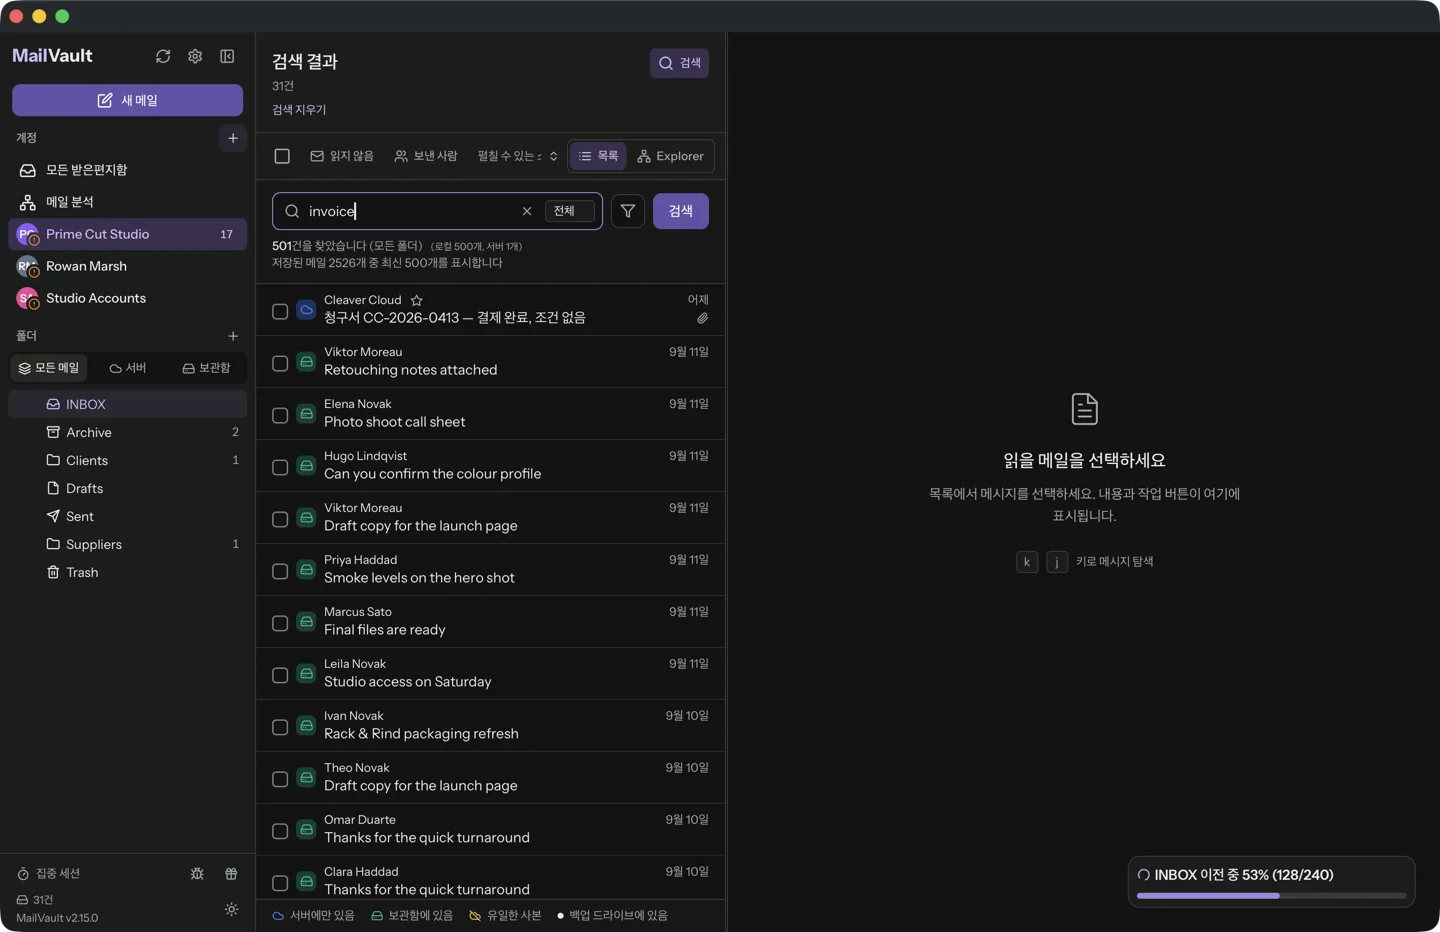
규모를 실감하도록 짚어 보면, 60 Hz 화면은 16.7 ms마다 다시 그려지고 위의 모든 쿼리는 한 번 다시 그리는 시간 안에 끝납니다. 1993년 이후 바뀌지 않은 Jakob Nielsen의 응답 시간 한계는 “즉각적”에 0.1 s, 끊기지 않는 사고에 1 s, 주의 이탈에 10 s입니다. 우리의 가장 느린 응답은 첫 번째 한계의 7분의 1입니다. 아래 자는 로그 눈금이라 눈금 한 칸이 앞 칸의 열 배이며, 오른쪽 끝이 오프라인 검색의 첫 번째 버전이 있던 자리입니다.
직접 확인하기
벤치마크는 소스 트리에 있는 무시 처리된 테스트라서 평소 실행을 느리게 하지 않습니다. 임시 디렉터리에 코퍼스를 만들고, 실제 MIME 파서로 인덱싱한 다음, 위의 모든 줄을 출력합니다.
cargo test -p mailvault-daemon --release \
  search_index_bench_50k_real_parser -- --ignored --nocapture
코퍼스는 쿼리를 실행하기 직전에 새 디렉터리에 쓰이므로 페이지 캐시는 데워진 상태입니다. 재부팅 후 첫 검색은 디스크에서 더 많이 읽습니다. 이 경우는 측정하지 않았고 주장하지도 않습니다.
검색 엔진이 아니라 평범한 SQL 데이터베이스인 이유
요구 사항은 화려하지 않았습니다. 볼트는 외부 드라이브나 NAS 마운트로 옮길 수 있으므로 인덱스는 볼트 안에 있어야 합니다. 오프라인에서 작동해야 합니다. 버렸다가 다시 만들 수 있는 파생 데이터여야 합니다. 그리고 사용자에게 시작하고, 패치하고, 설명해야 하는 서비스를 하나 더 얹어서는 안 됩니다.
그것이 FTS5 전문 검색 모듈을 갖춘 SQLite입니다. 프로세스 하나가 여는 파일 하나이며, 볼트가 네트워크 공유에 있을 수 있으므로 독점 잠금과 함께 write-ahead-log 모드로 씁니다. 텍스트는 가상 테이블 두 개가 담습니다.
- 라틴 문자 텍스트를 위한 trigram 테이블. 모든 단어가 세 글자씩 겹치는 조각으로 저장되므로
voic검색은invoice를 찾아내며, 와일드카드 문법도 단어 전체 일치 규칙도 필요 없습니다. 분음 기호는 무시되므로reunion검색은Réunion을 찾아냅니다. 한 글자나 두 글자짜리 쿼리는 trigram보다 짧으므로 제목과 보낸 사람에 대한 단순 부분 문자열 일치로 넘어갑니다. - CJK를 위한 두 번째 테이블. 일본어와 중국어는 나눌 띄어쓰기가 없고 단어가 두 글자인 경우가 많아 trigram보다 짧으므로, 글자를 하나씩 나눈 다음 그것들을 구문으로 일치시키는 토크나이저를 거칩니다. 이것이 없으면 검색어
会議는 아무것도 찾지 못합니다.
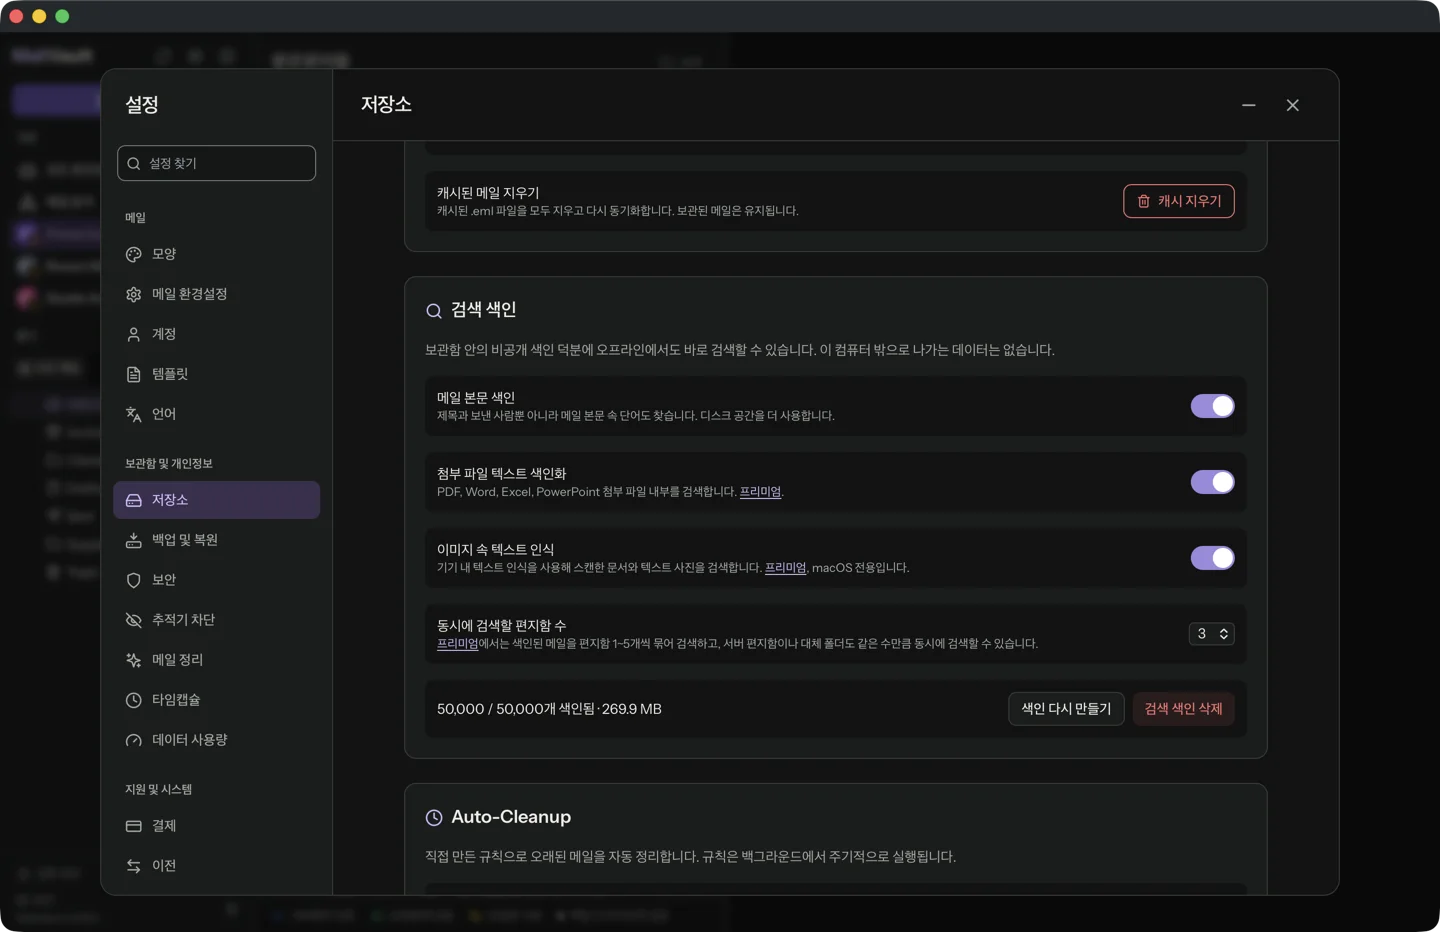
두 테이블 모두 내용이 없는(contentless) 구조입니다. 검색 구조만 담고 메일의 두 번째 사본은 담지 않으며, 이것이 메시지 50,000개가 225 MB에 들어가는 큰 이유입니다.
검색은 메시지를 열지 않습니다
목록은 각 결과의 보낸 사람, 제목, 날짜, 폴더, 플래그가 필요합니다. 그것을 얻으려고 메시지 파일 500개를 파싱하면 쿼리보다 비용이 더 듭니다. 그래서 인덱스 행에는 이미 만들어 둔 목록 행을 저장하고, 현재 플래그는 maildir 형식이 플래그를 두는 파일 이름에서 읽습니다. 벤치마크는 결과를 조립하는 동안 MIME 파서가 호출된 횟수를 세는데, 답은 0입니다.
메시지는 클릭했을 때만 열리며, 그때 인덱스가 기록해 둔 Message-ID와 대조하므로 서버가 다시 발급한 UID 때문에 엉뚱한 메일이 표시되는 일은 없습니다.
인덱스를 정확하게 유지하기
볼트와 어긋나는 인덱스는 없느니만 못합니다. "삭제할 때 인덱스도 함께 갱신"하는 긴 훅 사슬은 없습니다. 조정기 하나가 폴더 목록(uid, 파일 이름, 크기, 수정 시각)을 인덱스가 담고 있는 것과 비교해 차이를 바로잡습니다. 모든 기록 주체는 조정기를 깨우기만 합니다. 파일이 손상되었거나 더 새로운 스키마의 것이면 삭제하고 메일로부터 다시 만들며, 복구 코드는 파생된 인덱스 파일 네 개만 지웁니다. 메시지, 보관 기록, 계정은 절대 건드리지 않습니다.
첫 번째 버전은 대신 무엇을 했나
첫 번째 오프라인 검색은 파일을 읽었습니다. 검색할 때마다 폴더를 나열하고, 새 디렉터리 스캔으로 메시지를 UID별로 찾아 파싱하고, 모든 본문을 프로세스 경계 너머로 직렬화해 보내고, JavaScript에서 걸렀습니다. 그중 한 부분을 측정했습니다. 메시지 20,000개짜리 폴더에서 디렉터리 재스캔 한 번에 약 4.4 ms가 들고 이것이 메시지마다 한 번씩 실행되므로, 그 폴더 하나에만 대략 88초가 걸리는 셈입니다. 그래서 인덱스가 존재하고, 파일을 열지 않는 검색이 최적화가 아니라 설계상의 제약인 이유입니다.
우리가 출시한 속도 저하
이 글의 숫자를 준비하던 중 벤치마크가 실패했습니다. 2.15.0 릴리스를 포함한 코드에서 "invoice"는 221 ms, "budget meeting"은 500 ms가 걸렸고, 테스트 자체의 200 ms 단언은 세 번 모두 걸렸습니다. 9월 13일에는 같은 쿼리의 검색 단계가 4~7 ms로 측정되었습니다.
원인은 부주의하게 추가한 좋은 기능이었습니다. 리더에서 일치한 용어를 강조하고 첨부 파일 안에서만 발견된 결과를 표시하기 위해, 각 결과 행에 본문이 일치하는가, 첨부 파일 텍스트가 일치하는가라는 두 가지 질문을 붙였습니다. 각각은 전문 검색 테이블에 한 번에 한 행씩 묻는 서브쿼리로 작성되었고, 이런 상관 서브쿼리는 묻는 행마다 다시 실행됩니다. 실행할 때마다 용어의 포스팅을 처음부터 다시 훑으므로 비용은 쿼리 용어에 따라 달라집니다. 일치가 246건인 두 단어 구문(500 ms)이 약 2,500건인 한 단어(221 ms)보다 느렸습니다.
수정은 모양 한 줄입니다. 인덱스에 일치하는 행의 집합을 한 번만 묻고, 그 집합에 속하는지를 검사합니다. 결과는 같고, 기존 쿼리 테스트 18개는 그대로이며 가드 테스트가 하나 늘었고, 네 수치는 7.4, 14.0, 14.0, 4.5 ms로 떨어졌습니다. 교훈은 따분한 것입니다. 200 ms 게이트는 있었지만 메시지 50,000개를 만드는 데 20초가 걸려서 ignore가 붙어 있었습니다. 아무도 실행하지 않는 게이트는 문서일 뿐이므로, 이번 수정에는 일반 테스트 실행에서 도는 가드가 함께 들어갑니다.
첨부 파일과 Vision, Premium 쪽 절반
본문은 무료입니다. 첨부 파일 텍스트는 Premium 옵션이며, 같은 인덱스에 열 하나를 더하는 방식으로 붙으므로 검색 한 번으로 메시지와 그 안의 문서를 함께 찾습니다.
- Office 파일 (Word, Excel, PowerPoint)는 XML을 담은 zip 아카이브이며, 모든 플랫폼에서 순수 Rust로 읽습니다.
- PDFs 텍스트 레이어를 사용합니다. macOS에서는 PDFKit, 그 밖의 환경에서는 별도의
pdf-extract프로세스를 씁니다. - 이미지와 스캔한 PDF 는 macOS에서 Apple의 Vision 프레임워크를 거치며, 기기 안에서 처리되고 문서당 최대 50쪽으로 제한됩니다. 작은 이미지(10 KB 미만이거나 짧은 변이 128픽셀 미만)는 읽을 수 있는 텍스트를 담기에 너무 작다고 보고 건너뜁니다. Windows와 Linux에는 OCR 단계가 없습니다.
한도는 의도한 것입니다. 파트당 25 MB, 아카이브는 압축을 푼 크기 50 MB이며, 읽을 수 없는 파일은 재시도 루프가 아니라 기록된 상태가 됩니다. I/O 오류 같은 일시적 실패는 다음 스윕에서 다시 시도하고, 정말로 지원하지 않는 파일은 영원히 시도하지 않도록 표시합니다. 이 글을 위해 추출 시간은 재지 않았습니다. 추출은 첨부 파일마다 한 번씩 백그라운드에서 실행되며 비용은 사용자의 파일에 달려 있습니다.
다른 클라이언트는 자기 검색을 어떻게 설명하나
어느 클라이언트도 벤치마크하지 않았고, 메시지 50,000개에서의 시간을 공개한 곳도 없으므로 이것은 스톱워치가 아니라 설계를 비교한 것입니다. Apple 공식 안내 기준으로 Spotlight의 첫 인덱싱에는 몇 시간, 심지어 며칠이 걸릴 수 있습니다. Microsoft 문서 기준으로 기존 Outlook의 검색은 Windows Search 인덱스에 의존하고, 인덱싱이 끝날 때까지 결과가 불완전할 수 있으며, 캐시된 메일만 인덱싱됩니다. Thunderbird의 트래커에는 대용량 메일함에서 전역 인덱싱이 느려진다는 16년 된 보고 사례가 있으며, 한 사용자는 듀얼코어 컴퓨터에서 메시지 36,000개에 며칠이 걸렸다고 적었습니다. 이는 일화이고 오래된 하드웨어에서의 일이라서, 우리 결과와 비교하지 않겠습니다.
이 결과가 보여 주지 않는 것
메일은 합성 데이터이고 짧습니다. 실제 메시지는 더 길고 인덱스는 본문 텍스트에 따라 커집니다. 모든 측정은 Mac 한 대의 웜 캐시 기준입니다. 첨부 파일 검색은 시간을 재지 않았습니다. 서버에만 있는 메일은 인덱스에 전혀 없습니다. MailVault는 서버에 물어보고 로컬 결과를 먼저 나열하며, 그 구간은 제공업체에 좌우되므로 여기에는 숫자가 없습니다. Premium에서는 서버 편지함 하나 대신 최대 다섯 개를 한꺼번에 검색합니다.
이메일 50,000통, 눈 깜짝할 사이. MailVault는 보관함 옆에 비공개 검색 인덱스를 둡니다. 본문은 무료이고, 첨부 파일과 기기 안에서 처리하는 이미지 텍스트는 Premium에서 지원합니다.
MailVault 받기 →