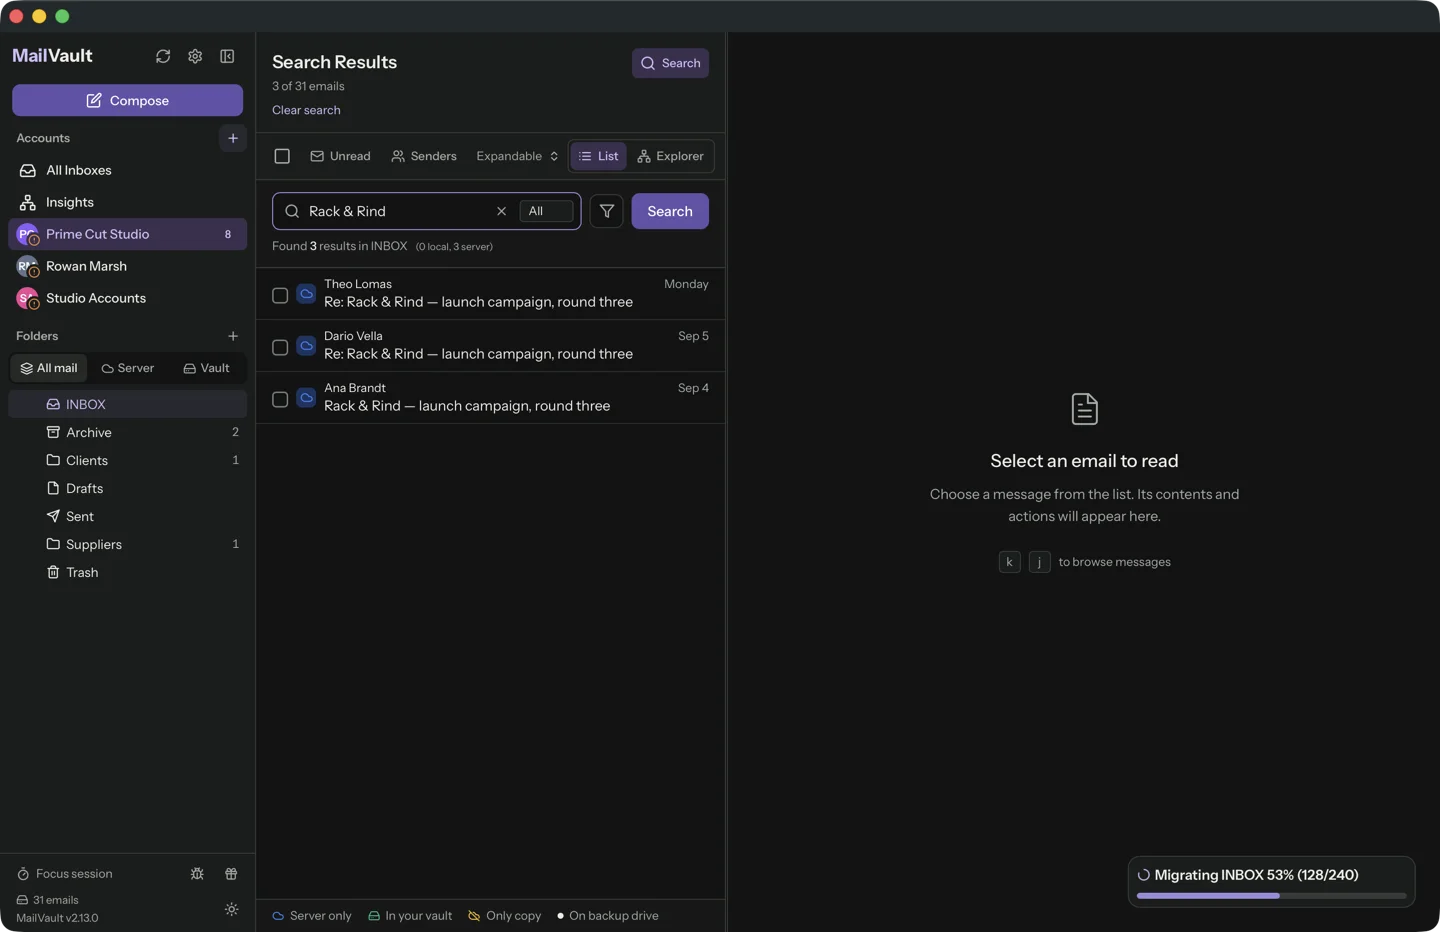
Per la maggior parte dei client di posta la ricerca è una funzione. Per noi è un budget di latenza. L’intera ragion d’essere di MailVault è che tieni decenni di posta sul tuo disco, e un archivio in cui non puoi cercare in meno di un battito di cuore è una discarica.
Così abbiamo costruito un vault da 50.000 messaggi e l’abbiamo cronometrato. La query più lenta ha impiegato 14 millisecondi. La parte interessante è quello che è servito per arrivarci, e la release in cui l’abbiamo reso 30 volte più lento senza accorgercene.
I numeri
Una macchina, cinque forme di query, sei esecuzioni ciascuna (tre su una build di prova della correzione, tre sul codice integrato). I tempi comprendono la ricerca più la composizione delle righe che l’elenco disegna:
MailVault daemon · release build · Apple M4, 16 GB · warm cache
50,000 synthetic messages, avg 3,334 bytes, 3 folders

query                    matches   rows    time (6 runs)
invoice                  ~2,500    500     7.1 – 7.5 ms
budget meeting           246       246     13.4 – 14.1 ms
update 4999              15        15      13.5 – 14.0 ms
会議                    1,529     500     4.3 – 4.6 ms
last 7 days, no words    1,008     500     1.0 ms

index build (cold)       50,000 msgs   10.9 – 11.9 s
index on disk            224,968,704 bytes
result-row parses        0
Il corpus è generato, non è posta reale: 200 parole di riempimento per messaggio, in testo semplice e in HTML, più dieci parole inserite a frequenze fisse (invoice 5%, budget 8%, meeting 6%, con tre termini giapponesi e con accenti tra queste) in modo che ogni query abbia una dimensione di risposta nota. Il generatore è deterministico, quindi una nuova esecuzione ricostruisce gli stessi 50.000 file. La macchina era condivisa con altre build mentre i test giravano, quindi questo è un computer occupato, non un laboratorio.
Per rendere concreta la scala: un display a 60 Hz ridisegna lo schermo ogni 16,7 ms, e ogni query qui sopra finisce entro un solo ridisegno. I limiti di risposta di Jakob Nielsen, invariati dal 1993, sono 0,1 s per l’«istantaneo», 1 s per il pensiero ininterrotto e 10 s per la perdita di attenzione. La nostra risposta più lenta è un settimo del primo limite. Il righello qui sotto è logaritmico, ogni tacca vale dieci volte la precedente, e alla sua estremità destra viveva la prima versione della ricerca offline.
Verificalo da solo
Il benchmark è un test ignorato nell’albero dei sorgenti, così non rallenta mai le esecuzioni ordinarie. Costruisce il corpus in una directory temporanea, lo indicizza con il vero parser MIME e stampa ogni riga qui sopra:
cargo test -p mailvault-daemon --release \
  search_index_bench_50k_real_parser -- --ignored --nocapture
Il corpus viene scritto in una directory nuova subito prima dell’esecuzione delle query, quindi la cache delle pagine è calda. La prima ricerca dopo un riavvio legge di più dal disco. Non abbiamo misurato quel caso e non lo rivendichiamo.
Perché un semplice database SQL e non un motore di ricerca
I requisiti erano poco affascinanti. L’indice deve stare dentro il vault, perché il vault può essere spostato su un disco esterno o su un mount NAS. Deve funzionare offline. Deve essere un dato derivato che possiamo buttare e ricostruire. E non deve aggiungere un servizio da avviare, aggiornare o spiegare a un utente.
Questo è SQLite con il suo modulo full-text FTS5. Un file, aperto da un solo processo, in modalità write-ahead log con un lock esclusivo, scelta perché il vault può trovarsi su una condivisione di rete. Due tabelle virtuali contengono il testo:
- Una tabella trigram per il testo latino. Ogni parola è memorizzata come pezzi sovrapposti di tre lettere, così
voictrovainvoice, senza sintassi con caratteri jolly e senza la regola della parola intera. I segni diacritici vengono normalizzati, cosìreuniontrovaRéunion. Le query di una o due lettere sono più corte di un trigramma, quindi ricadono su una semplice corrispondenza di sottostringa su oggetto e mittente. - Una seconda tabella per il CJK. Giapponese e cinese non hanno spazi su cui dividere e le loro parole sono spesso di due caratteri, più corte di un trigramma, quindi passano per un tokenizzatore che le divide in singoli caratteri e li confronta come frase. Senza di esso, una ricerca di
会議non trova nulla.
Entrambe le tabelle sono contentless: contengono le strutture di ricerca e non una seconda copia della tua posta, il che spiega in buona parte perché 50.000 messaggi stanno in 225 MB.
La ricerca non apre mai un messaggio
L’elenco ha bisogno di mittente, oggetto, data, cartella e flag per ogni risultato. Analizzare 500 file di messaggio per ottenerli costerebbe più della query. Perciò la riga dell’indice memorizza la riga dell’elenco già costruita, e i flag correnti vengono letti dal nome del file, dove il formato maildir li conserva. Il benchmark conta le chiamate al parser MIME mentre i risultati vengono composti, e la risposta è zero.
Il messaggio viene aperto solo quando lo clicchi, e a quel punto viene confrontato con il Message-ID che l’indice ha registrato, così un UID riassegnato da un server non può mostrarti la posta sbagliata.
Tenere l’indice onesto
Un indice che si discosta dal vault è peggio di nessun indice. Non c’è una lunga catena di hook del tipo «alla cancellazione, aggiorna anche l’indice». Un solo riconciliatore confronta l’elenco della cartella (uid, nome file, dimensione, data di modifica) con ciò che l’indice contiene e ripara la differenza. Ogni scrittore si limita a sollecitarlo. Se il file è danneggiato o proviene da uno schema più recente, viene eliminato e ricostruito dalla posta, e il codice di recupero rimuove soltanto i quattro file derivati dell’indice. Messaggi, registri di custodia e account non vengono mai toccati.
Che cosa faceva la prima versione
La prima ricerca offline leggeva i file. Ogni ricerca elencava la cartella, cercava ogni messaggio per UID con una nuova scansione della directory, lo analizzava, serializzava ogni corpo attraverso il confine del processo e filtrava in JavaScript. Ne abbiamo misurato una parte: una nuova scansione della directory costa circa 4,4 ms su una cartella da 20.000 messaggi, e veniva eseguita una volta per messaggio, il che porta a una stima di circa 88 secondi per quella sola cartella. Ecco perché l’indice esiste, e perché una ricerca che non apre alcun file è il vincolo di progetto e non un’ottimizzazione.
Il rallentamento che abbiamo rilasciato
Mentre preparavamo i numeri per questa nota, il benchmark è fallito. Sul codice che include la release 2.15.0, «invoice» ha impiegato 221 ms, «budget meeting» 500 ms, e la stessa asserzione dei 200 ms del test è scattata in tutte e tre le esecuzioni. Il 13 settembre il passaggio di ricerca della stessa query era stato misurato tra 4 e 7 ms.
La causa era una buona funzione aggiunta con leggerezza. Per evidenziare i termini trovati nel lettore e per contrassegnare i risultati trovati solo dentro un allegato, a ogni riga di risultato erano state poste due domande: il corpo corrisponde, il testo dell’allegato corrisponde. Ciascuna era scritta come una sottoquery che interroga la tabella full-text su una riga alla volta, e una sottoquery correlata di questo tipo viene rieseguita per ogni riga su cui viene interrogata. A ogni esecuzione rilegge le liste di occorrenze del termine, quindi il prezzo dipende dai termini della query: una frase di due parole con 246 risultati (500 ms) era più lenta di una parola singola con circa 2.500 (221 ms).
La correzione è una riga di forma: chiedere all’indice una sola volta l’insieme delle righe corrispondenti e verificare l’appartenenza a quell’insieme. Stessi risultati, tutti i 18 test di query esistenti invariati e un nuovo test di guardia, e le quattro cifre sono scese a 7,4, 14,0, 14,0 e 4,5 ms. La lezione è la più noiosa. La soglia dei 200 ms esisteva ed era marcata come ignorata, perché costruire 50.000 messaggi richiede venti secondi. Una soglia che nessuno esegue è documentazione, perciò la correzione arriva con una guardia che gira nelle normali esecuzioni dei test.
Allegati e Vision, la metà Premium
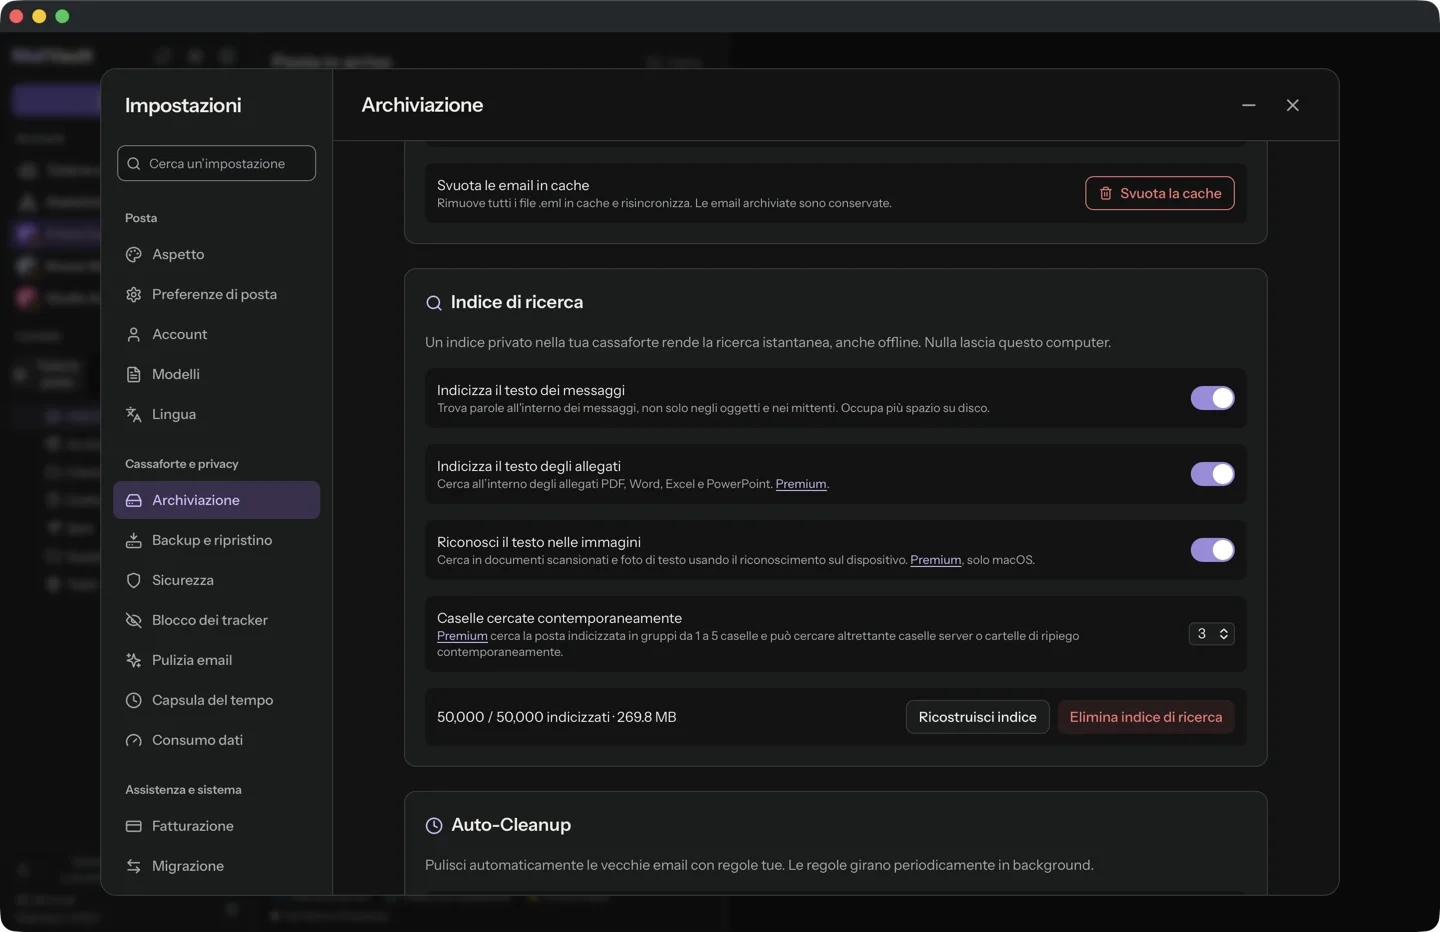
I corpi dei messaggi sono gratuiti. Il testo degli allegati è un’opzione Premium, e si innesta nello stesso indice come una colonna in più, così una ricerca trova insieme i messaggi e i documenti che contengono.
- File Office (Word, Excel, PowerPoint) sono archivi zip di XML e vengono letti in puro Rust su ogni piattaforma.
- PDF usano il livello di testo: PDFKit su macOS, altrove un processo
pdf-extractseparato. - Immagini e PDF scansionati passano dal framework Vision di Apple su macOS, sul dispositivo, con un limite di 50 pagine per documento. Le immagini piccole (sotto i 10 KB o 128 pixel sul lato corto) vengono saltate perché troppo piccole per contenere testo leggibile. Windows e Linux non hanno alcun passaggio di OCR.
I limiti sono voluti: 25 MB per parte, 50 MB non compressi per un archivio, e un file illeggibile diventa uno stato registrato, mai un ciclo di tentativi. Un errore transitorio come un errore di I/O viene ritentato alla scansione successiva, e un file davvero non supportato viene contrassegnato così da non riprovarlo all’infinito. Per questa nota non abbiamo misurato l’estrazione. Viene eseguita una volta per allegato in background, e il suo costo dipende dai tuoi file.
Che cosa dicono gli altri della loro ricerca
Non ne abbiamo misurato nessuno, e nessuno pubblica tempi a 50.000 messaggi, quindi questi sono progetti e non cronometri. Apple afferma che la prima indicizzazione di Spotlight può richiedere ore o addirittura giorni. Microsoft documenta che la ricerca di Outlook classico dipende dall’indice di Windows Search, che i risultati possono essere incompleti finché non termina, e che viene indicizzata solo la posta in cache. Il tracker di Thunderbird ha una segnalazione vecchia di sedici anni sul rallentamento dell’indicizzazione globale su caselle grandi, con un utente che cita diversi giorni per 36.000 messaggi su una macchina dual-core. È aneddotico e riguarda hardware datato, e non lo confronteremmo con il nostro.
Che cosa questo non dimostra
La posta è sintetica e breve, i messaggi reali sono più lunghi e l’indice cresce con il testo dei corpi. Tutto è stato misurato a cache calda su un solo Mac. La ricerca negli allegati non è stata cronometrata. La posta che vive solo sul server non è affatto nell’indice: MailVault interroga il server, elenca prima i risultati locali, e quel tratto dipende dal provider, quindi qui non ha un numero. Premium cerca fino a cinque caselle server contemporaneamente invece di una.
Cinquantamila email, un battito di cuore. MailVault tiene un indice di ricerca privato accanto al tuo archivio: i corpi gratis, gli allegati e il testo delle immagini sul dispositivo con Premium.
Scarica MailVault →