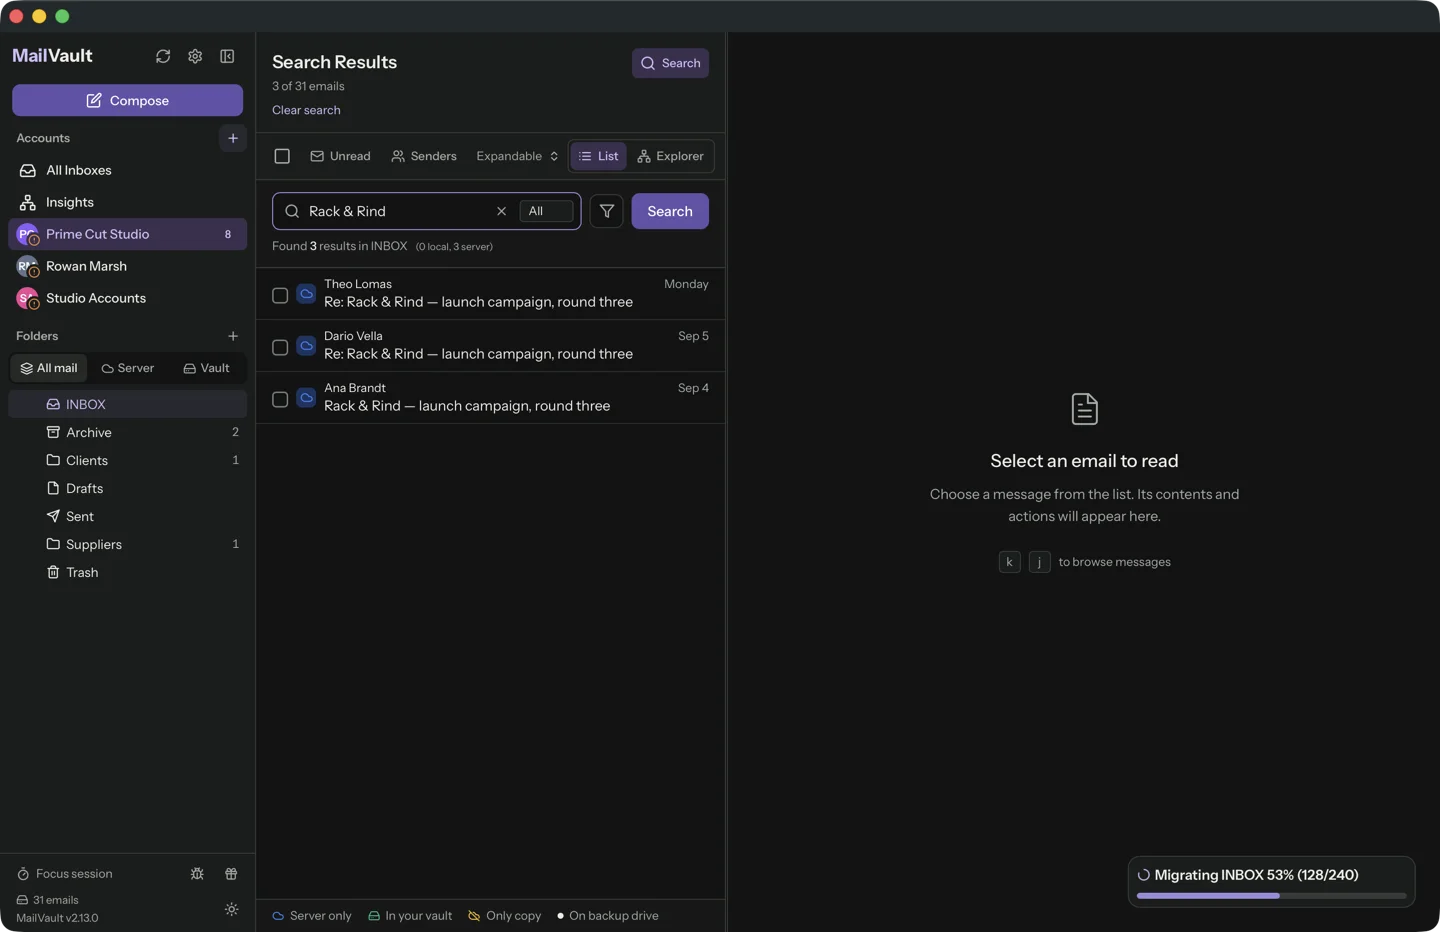
La mayoría de los clientes de correo tratan la búsqueda como una función. Nosotros la tratamos como un presupuesto de latencia. La razón de ser de MailVault es que guardes décadas de correo en tu propio disco, y un archivo en el que no puedes buscar en menos de un latido es un vertedero.
Así que construimos una bóveda de 50 000 mensajes y la cronometramos. La consulta más lenta tardó 14 milisegundos. Lo interesante es lo que costó llegar ahí y la versión en la que la hicimos 30 veces más lenta sin darnos cuenta.
Los números
Una máquina, cinco tipos de consulta, seis ejecuciones de cada una (tres sobre una compilación de prueba de la corrección y tres sobre el código integrado). Los tiempos son la búsqueda más el montaje de las filas que dibuja la lista:
MailVault daemon · release build · Apple M4, 16 GB · warm cache
50,000 synthetic messages, avg 3,334 bytes, 3 folders

query                    matches   rows    time (6 runs)
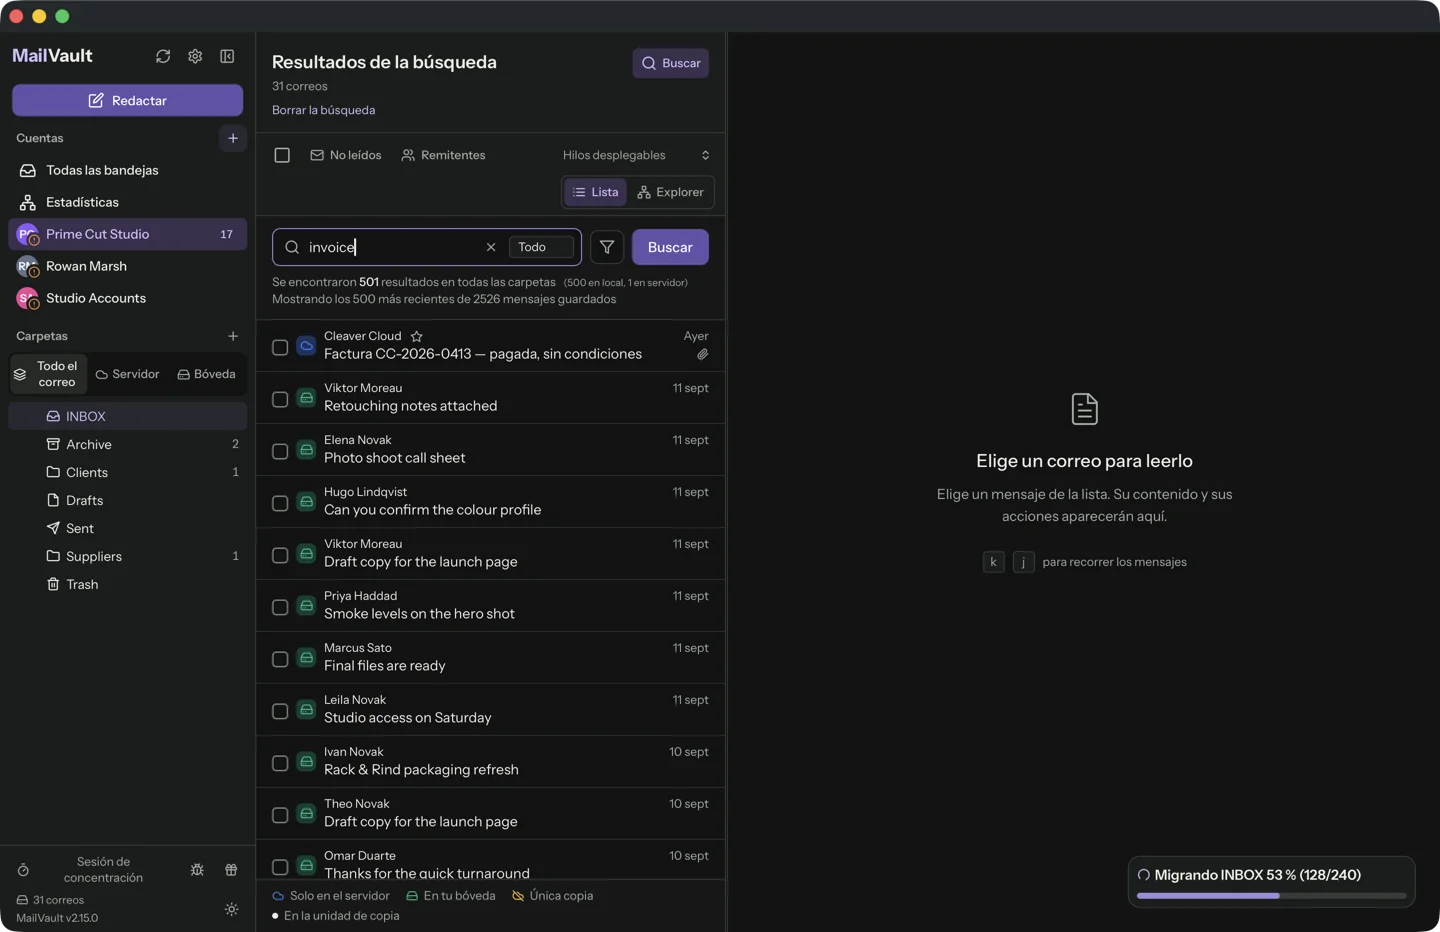
invoice                  ~2,500    500     7.1 – 7.5 ms
budget meeting           246       246     13.4 – 14.1 ms
update 4999              15        15      13.5 – 14.0 ms
会議                    1,529     500     4.3 – 4.6 ms
last 7 days, no words    1,008     500     1.0 ms

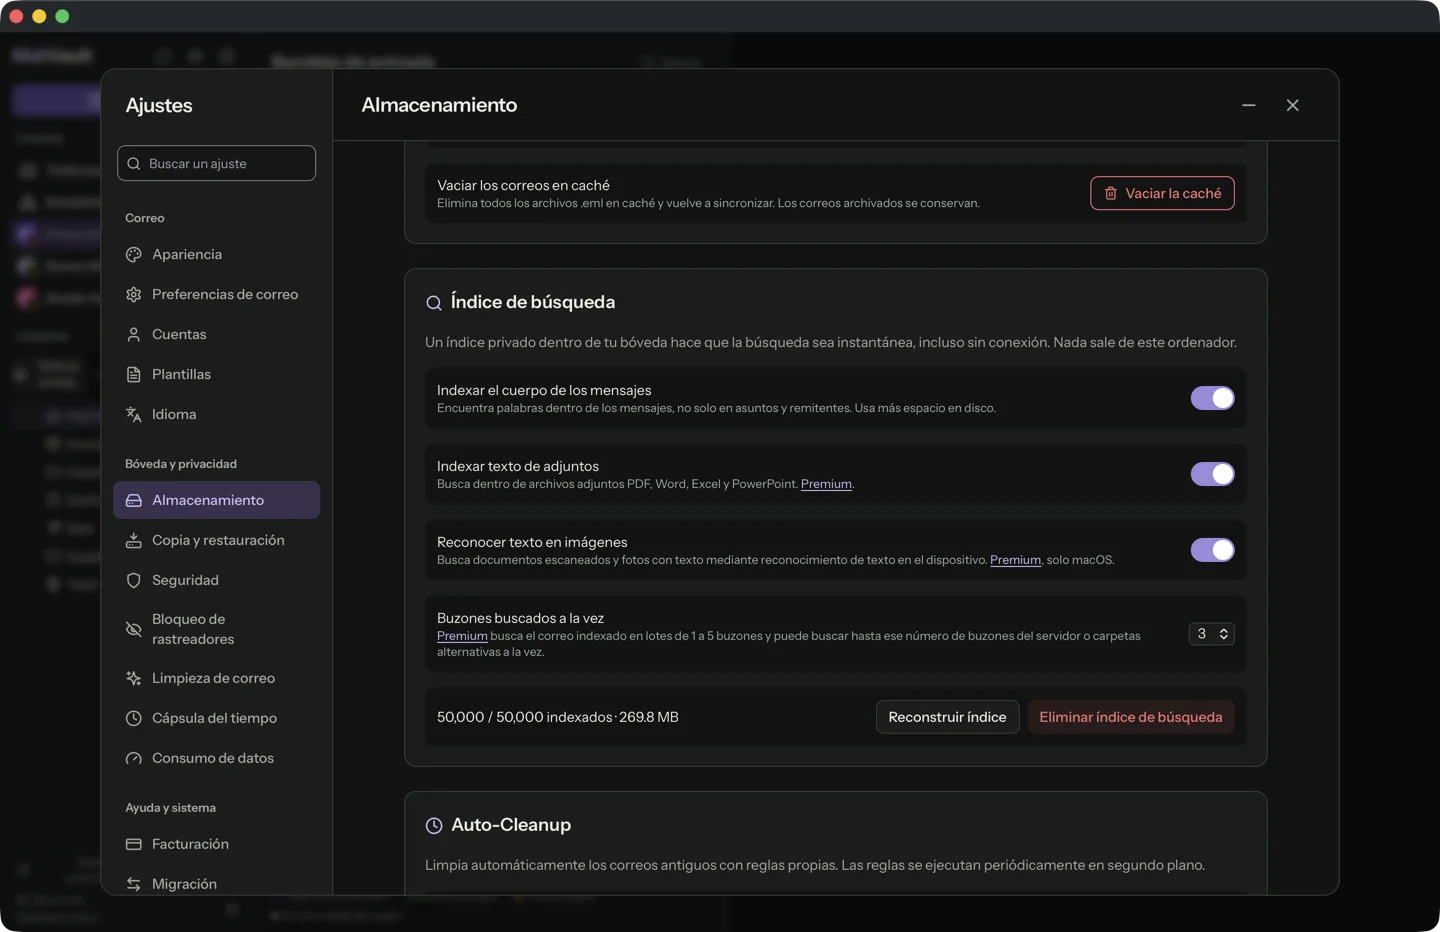
index build (cold)       50,000 msgs   10.9 – 11.9 s
index on disk            224,968,704 bytes
result-row parses        0
El corpus es generado, no correo real: 200 palabras de relleno por mensaje en texto plano y HTML, más diez palabras plantadas a tasas fijas (invoice 5 %, budget 8 %, meeting 6 %, tres términos japoneses y con acentos entre ellas) para que cada consulta tenga un tamaño de respuesta conocido. El generador es determinista, así que una nueva ejecución construye los mismos 50 000 archivos. La máquina se compartió con otras compilaciones mientras corrían las pruebas, así que esto es un ordenador ocupado, no un laboratorio.
Para poner la escala en concreto: una pantalla de 60 Hz se redibuja cada 16.7 ms, y todas las consultas de arriba terminan dentro de un solo redibujado. Los límites de respuesta de Jakob Nielsen, sin cambios desde el 1993, son 0.1 s para lo «instantáneo», 1 s para el pensamiento ininterrumpido y 10 s para la atención perdida. Nuestra respuesta más lenta es una séptima parte del primer límite. La regla de abajo es logarítmica, cada marca es diez veces la anterior, y en su extremo derecho vivía la primera versión de la búsqueda sin conexión.
Compruébalo tú mismo
El benchmark es un test ignorado del código fuente, así que nunca ralentiza las ejecuciones normales. Construye el corpus en un directorio temporal, lo indexa con el analizador MIME real e imprime todas las líneas de arriba:
cargo test -p mailvault-daemon --release \
  search_index_bench_50k_real_parser -- --ignored --nocapture
El corpus se escribe en un directorio nuevo justo antes de ejecutar las consultas, así que la caché de páginas está caliente. La primera búsqueda tras un reinicio lee más del disco. No hemos medido ese caso y no afirmamos nada sobre él.
Por qué una base de datos SQL sencilla y no un motor de búsqueda
Los requisitos eran poco glamurosos. El índice tiene que vivir dentro de la bóveda, porque la bóveda se puede mover a un disco externo o a un montaje NAS. Tiene que funcionar sin conexión. Tiene que ser un dato derivado que podamos tirar y reconstruir. Y no debe añadir un servicio que el usuario tenga que iniciar, parchear o entender.
Eso es SQLite con su módulo de texto completo FTS5. Un archivo, abierto por un proceso, en modo write-ahead log con bloqueo exclusivo, elegido porque la bóveda puede estar en un recurso de red compartido. Dos tablas virtuales guardan el texto:
- Una tabla trigram para texto latino. Cada palabra se guarda como fragmentos solapados de tres letras, así que
voicencuentrainvoice, sin sintaxis de comodines ni regla de palabra completa. Los diacríticos se normalizan, así quereunionencuentraRéunion. Las consultas de una y dos letras son más cortas que un trigram, así que recurren a una coincidencia simple de subcadena en asunto y remitente. - Una segunda tabla para CJK. El japonés y el chino no tienen espacios por los que dividir y sus palabras suelen tener dos caracteres, menos que un trigram, así que pasan por un tokenizador que las divide en caracteres sueltos y los busca como una frase. Sin él, una búsqueda de
会議no encuentra nada.
Ambas tablas son contentless: guardan las estructuras de búsqueda y no una segunda copia de tu correo, lo que explica en buena parte por qué 50 000 mensajes caben en 225 MB.
La búsqueda nunca abre un mensaje
La lista necesita remitente, asunto, fecha, carpeta y marcas para cada resultado. Analizar 500 archivos de mensaje para obtenerlos costaría más que la consulta. Por eso la fila del índice guarda la fila de la lista ya construida, y las marcas actuales se leen del nombre de archivo, donde el formato maildir las conserva. El benchmark cuenta las llamadas al analizador MIME mientras se ensamblan los resultados, y la respuesta es cero.
El mensaje solo se abre cuando haces clic en él, y entonces se comprueba contra el Message-ID que registró el índice, de modo que un UID que el servidor haya reasignado no pueda mostrarte el correo equivocado.
Que el índice no mienta
Un índice que se desvía de la bóveda es peor que ninguno. No hay una larga cadena de ganchos «al borrar, actualiza también el índice». Un único reconciliador compara el listado de la carpeta (uid, nombre de archivo, tamaño, fecha de modificación) con lo que contiene el índice y repara la diferencia. Cada escritor solo le da un aviso. Si el archivo está dañado o es de un esquema más nuevo, se borra y se reconstruye a partir del correo, y el código de recuperación solo elimina los cuatro archivos derivados del índice. Los mensajes, los registros de custodia y las cuentas nunca se tocan.
Lo que hacía en su lugar la primera versión
La primera búsqueda sin conexión leía archivos. Cada búsqueda listaba la carpeta, localizaba cada mensaje por UID con un nuevo escaneo del directorio, lo analizaba, serializaba cada cuerpo a través de la frontera entre procesos y filtraba en JavaScript. Medimos una de sus piezas: un reescaneo del directorio cuesta unos 4.4 ms en una carpeta de 20 000 mensajes, y se ejecutaba una vez por mensaje, lo que se proyecta en unos 88 segundos solo para esa carpeta. Por eso existe el índice, y por eso una búsqueda que no abre ningún archivo es la restricción de diseño y no una optimización.
La ralentización que publicamos
Mientras preparábamos las cifras de esta nota, el benchmark falló. Con el código que incluye la versión 2.15.0, «invoice» tardó 221 ms, «budget meeting» 500 ms, y la propia aserción de 200 ms del test saltó en las tres ejecuciones. El 13 de septiembre, el paso de búsqueda de la misma consulta había medido de 4 a 7 ms.
La causa fue una buena función añadida con descuido. Para resaltar los términos encontrados en el lector y marcar los resultados hallados solo dentro de un adjunto, a cada fila de resultado se le añadieron dos preguntas: ¿coincide el cuerpo?, ¿coincide el texto del adjunto? Cada una se escribió como una subconsulta que pregunta a la tabla de texto completo por una fila cada vez, y una subconsulta correlacionada así se vuelve a ejecutar por cada fila por la que se le pregunta. Cada ejecución recorre de nuevo las listas de apariciones (postings) del término, así que el precio depende de los términos de la consulta: una frase de dos palabras con 246 resultados (500 ms) fue más lenta que una sola palabra con unos 2 500 (221 ms).
La corrección es un cambio de forma de una línea: preguntar una vez al índice por el conjunto de filas coincidentes y comprobar la pertenencia a él. Mismos resultados, las 18 pruebas de consulta existentes sin cambios y una prueba de guarda nueva, y las cuatro cifras bajaron a 7.4, 14.0, 14.0 y 4.5 ms. La lección es la aburrida. El umbral de 200 ms existía y estaba marcado como ignorado, porque construir 50 000 mensajes lleva veinte segundos. Un umbral que nadie comprueba es documentación, así que la corrección se publica con una guarda que se ejecuta en las pruebas normales.
Adjuntos y Vision, la mitad Premium
Los cuerpos de mensaje son gratis. El texto de los adjuntos es una opción Premium y se conecta al mismo índice como una columna más, de modo que una búsqueda encuentra a la vez los mensajes y los documentos que llevan dentro.
- Archivos de Office (Word, Excel, PowerPoint) son archivos zip de XML y se leen en Rust puro en todas las plataformas.
- PDF usan la capa de texto: PDFKit en macOS, un proceso
pdf-extractindependiente en el resto de plataformas. - Imágenes y PDF escaneados pasan por el framework Vision de Apple en macOS, en el propio dispositivo, con un tope de 50 páginas por documento. Las imágenes pequeñas (menos de 10 KB o de 128 píxeles en el lado corto) se omiten por ser demasiado pequeñas para contener texto legible. Windows y Linux no tienen paso de OCR.
Los límites son deliberados: 25 MB por parte, 50 MB sin comprimir para un archivo comprimido, y un archivo ilegible pasa a ser un estado registrado, nunca un bucle de reintentos. Un fallo transitorio, como un error de E/S, se reintenta en la siguiente pasada, y un archivo realmente no compatible se marca para no intentarlo eternamente. No medimos la extracción para esta nota. Se ejecuta una vez por adjunto en segundo plano y su coste depende de tus archivos.
Lo que dicen los demás de los suyos
No hicimos benchmarks de ninguno de ellos, y ninguno publica tiempos con 50 000 mensajes, así que esto compara diseños y no cronómetros. Apple indica que la primera indexación de Spotlight puede tardar horas o incluso días. Microsoft documenta que la búsqueda del Outlook clásico depende del índice de Windows Search, que los resultados pueden estar incompletos hasta que termina, y que solo se indexa el correo en caché. El sistema de seguimiento de Thunderbird tiene un informe de hace dieciséis años sobre la ralentización de la indexación global en buzones grandes, con un usuario que cita varios días para 36 000 mensajes en una máquina de doble núcleo. Es anecdótico y de hardware antiguo, y no lo compararíamos con el nuestro.
Lo que esto no demuestra
El correo es sintético y corto, los mensajes reales son más largos y el índice crece con el texto de los cuerpos. Todo se midió con la caché caliente en un solo Mac. No se midió la búsqueda en adjuntos. El correo que solo vive en el servidor no está en el índice: MailVault pregunta al servidor, lista primero los resultados locales, y ese tramo lo limita el proveedor, así que aquí no tiene cifra. Premium busca en hasta cinco buzones del servidor a la vez en lugar de uno.
Cincuenta mil correos, un latido. MailVault guarda un índice de búsqueda privado junto a tu archivo: cuerpos de mensaje gratis, adjuntos y texto de imágenes en el dispositivo con Premium.
Obtén MailVault →