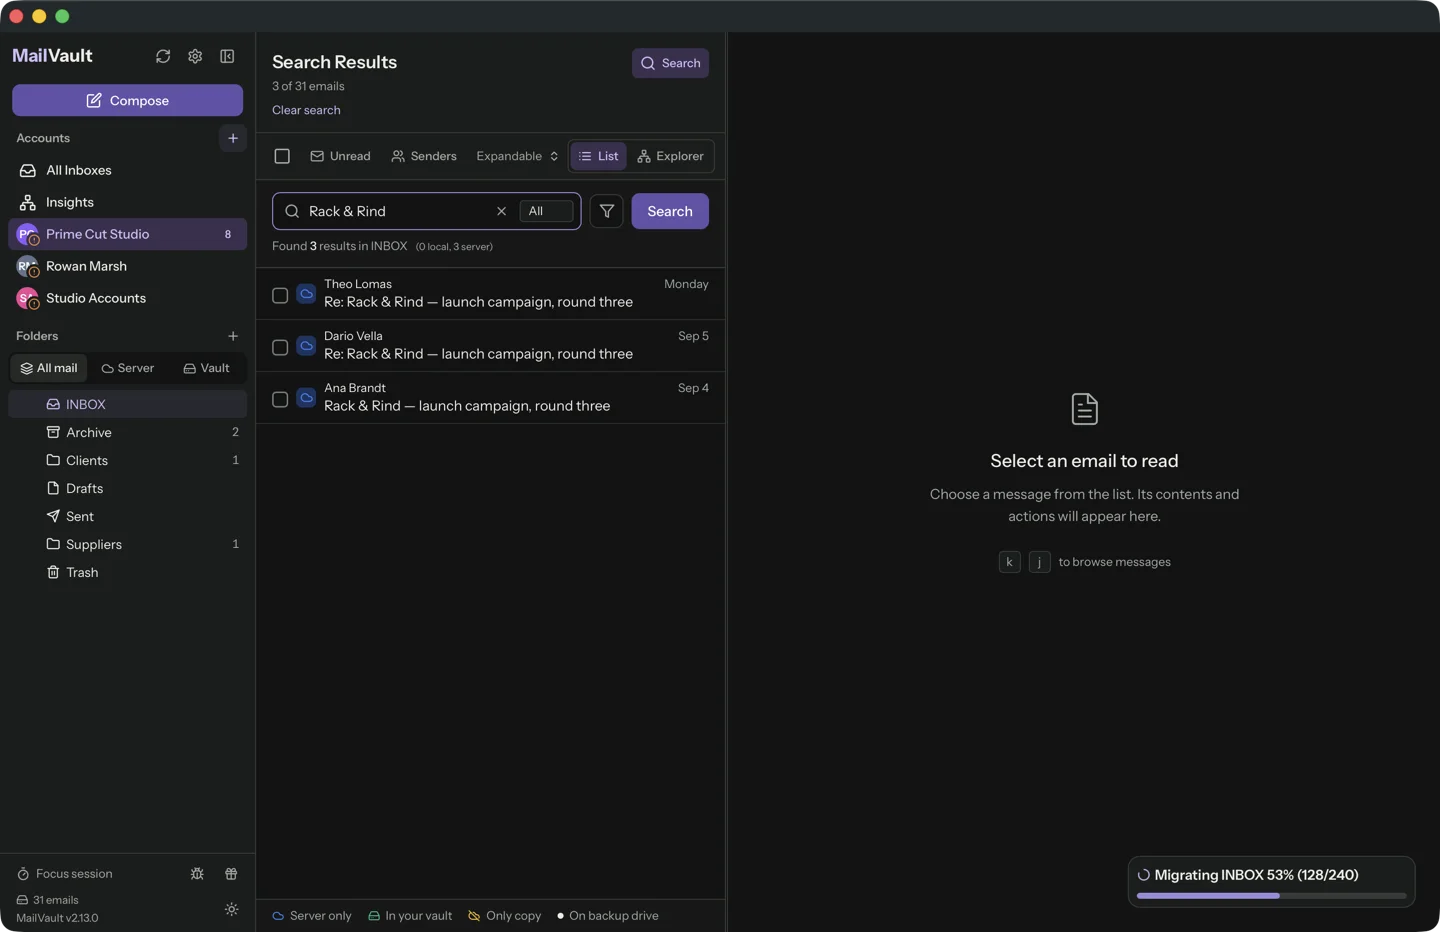
多くのメールクライアントは、検索を機能のひとつとして扱います。私たちは、レイテンシの予算として扱います。MailVault が存在する理由は、何十年分ものメールを自分のディスクに保管することにあります。ひと拍の間に検索できないアーカイブは、ゴミ捨て場です。
そこで 50,000 通の保管庫を作り、時間を測りました。最も遅いクエリで 14 ミリ秒でした。興味深いのは、そこに至るまでに何が必要だったかと、それを気づかないまま 30 倍遅くしてしまったリリースのことです。
数字
1 台のマシン、5 種類のクエリ、それぞれ 6 回の実行(修正を入れた作業用ビルドで 3 回、マージ後のコードで 3 回)。時間は、検索と、一覧が描画する行の組み立てを合わせたものです。
MailVault daemon · release build · Apple M4, 16 GB · warm cache
50,000 synthetic messages, avg 3,334 bytes, 3 folders

query                    matches   rows    time (6 runs)
invoice                  ~2,500    500     7.1 – 7.5 ms
budget meeting           246       246     13.4 – 14.1 ms
update 4999              15        15      13.5 – 14.0 ms
会議                    1,529     500     4.3 – 4.6 ms
last 7 days, no words    1,008     500     1.0 ms

index build (cold)       50,000 msgs   10.9 – 11.9 s
index on disk            224,968,704 bytes
result-row parses        0
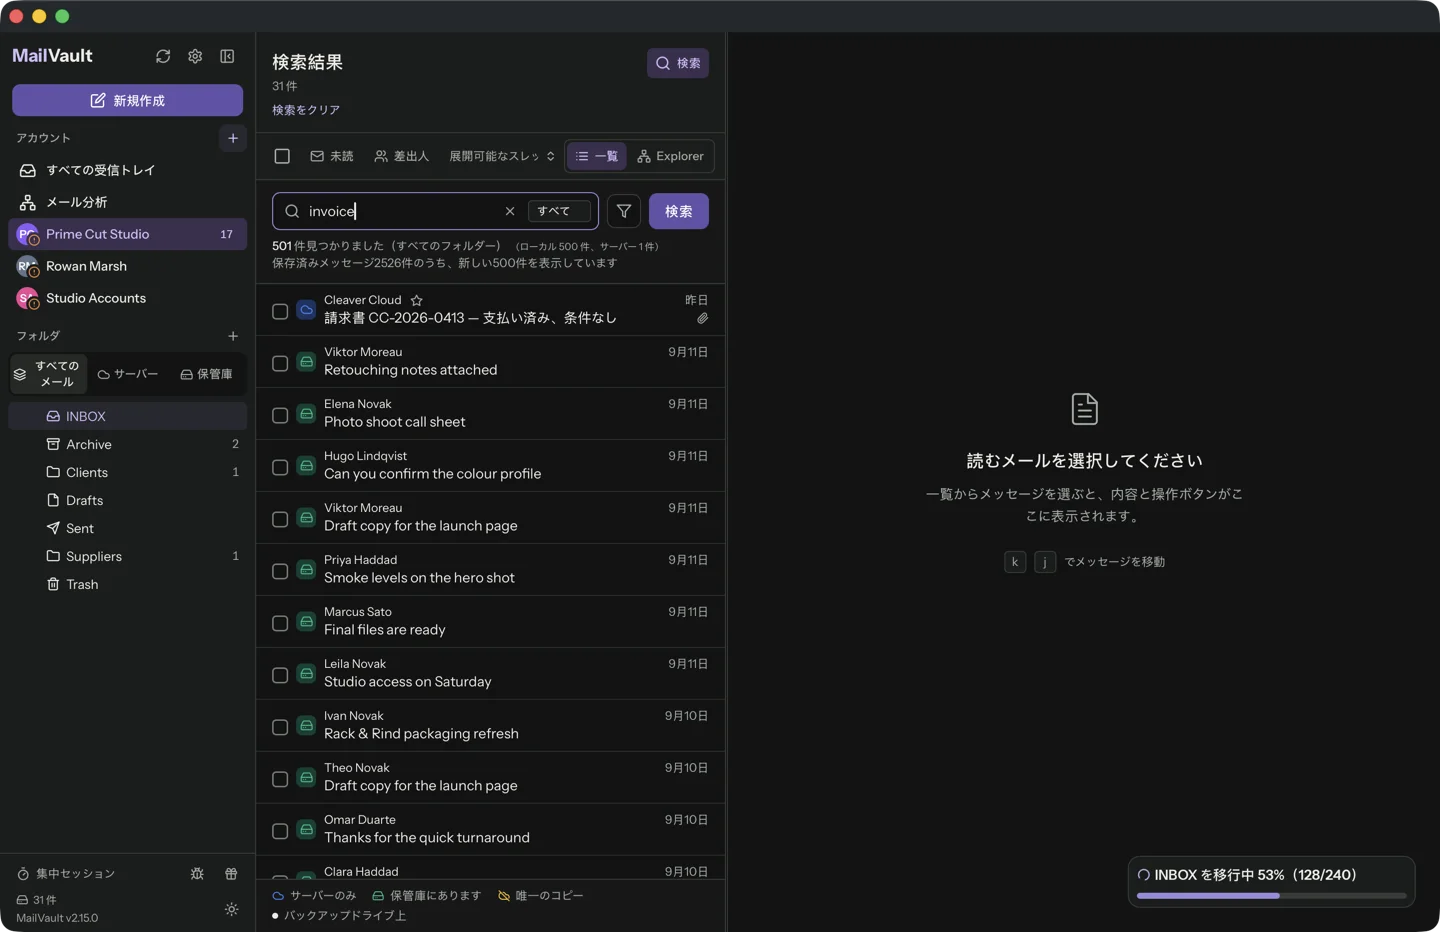
コーパスは実際のメールではなく生成したものです。1 通あたりプレーンテキストと HTML でそれぞれ 200 語のフィラー語を入れ、さらに 10 個の単語を固定の割合で仕込んでいます(invoice 5%、budget 8%、meeting 6%、その中に日本語とアクセント付きの用語が 3 つ)。そのため、どのクエリにも答えの件数が既知です。ジェネレーターは決定的なので、再実行すれば同じ 50,000 ファイルが作られます。テスト中、マシンは他のビルドと共有されていました。つまり、実験室ではなく、負荷のかかったコンピューターでの結果です。
尺度を具体的にすると、60 Hz のディスプレイは 16.7 ms ごとに再描画され、上のどのクエリも 1 回の再描画の間に終わります。1993 年から変わらない Jakob Nielsen の応答時間の限界は、「瞬時」が 0.1 s、思考が途切れないのが 1 s、注意が離れるのが 10 s です。私たちの最も遅い応答は、最初の限界の 7 分の 1 です。下の目盛りは対数で、1 つ進むごとに 10 倍になり、その右端が、オフライン検索の最初のバージョンがいた場所です。
自分で確かめる
ベンチマークはソースツリー内の無視指定のテストなので、通常の実行が遅くなることはありません。一時ディレクトリにコーパスを作り、実際の MIME パーサーでインデックスし、上の行をすべて出力します。
cargo test -p mailvault-daemon --release \
  search_index_bench_50k_real_parser -- --ignored --nocapture
コーパスはクエリを実行する直前に新しいディレクトリへ書き込まれるため、ページキャッシュは温まっています。再起動後の最初の検索では、ディスクからより多く読み込みます。このケースは測定していないので、主張もしません。
検索エンジンではなく、素朴な SQL データベースを選んだ理由
要件は地味なものでした。インデックスは保管庫の中に置く必要があります。保管庫は外付けドライブや NAS のマウント先に移せるからです。オフラインで動く必要があります。捨てて作り直せる派生データである必要があります。そして、ユーザーに起動させたり、パッチを当てさせたり、説明したりするサービスを増やしてはいけません。
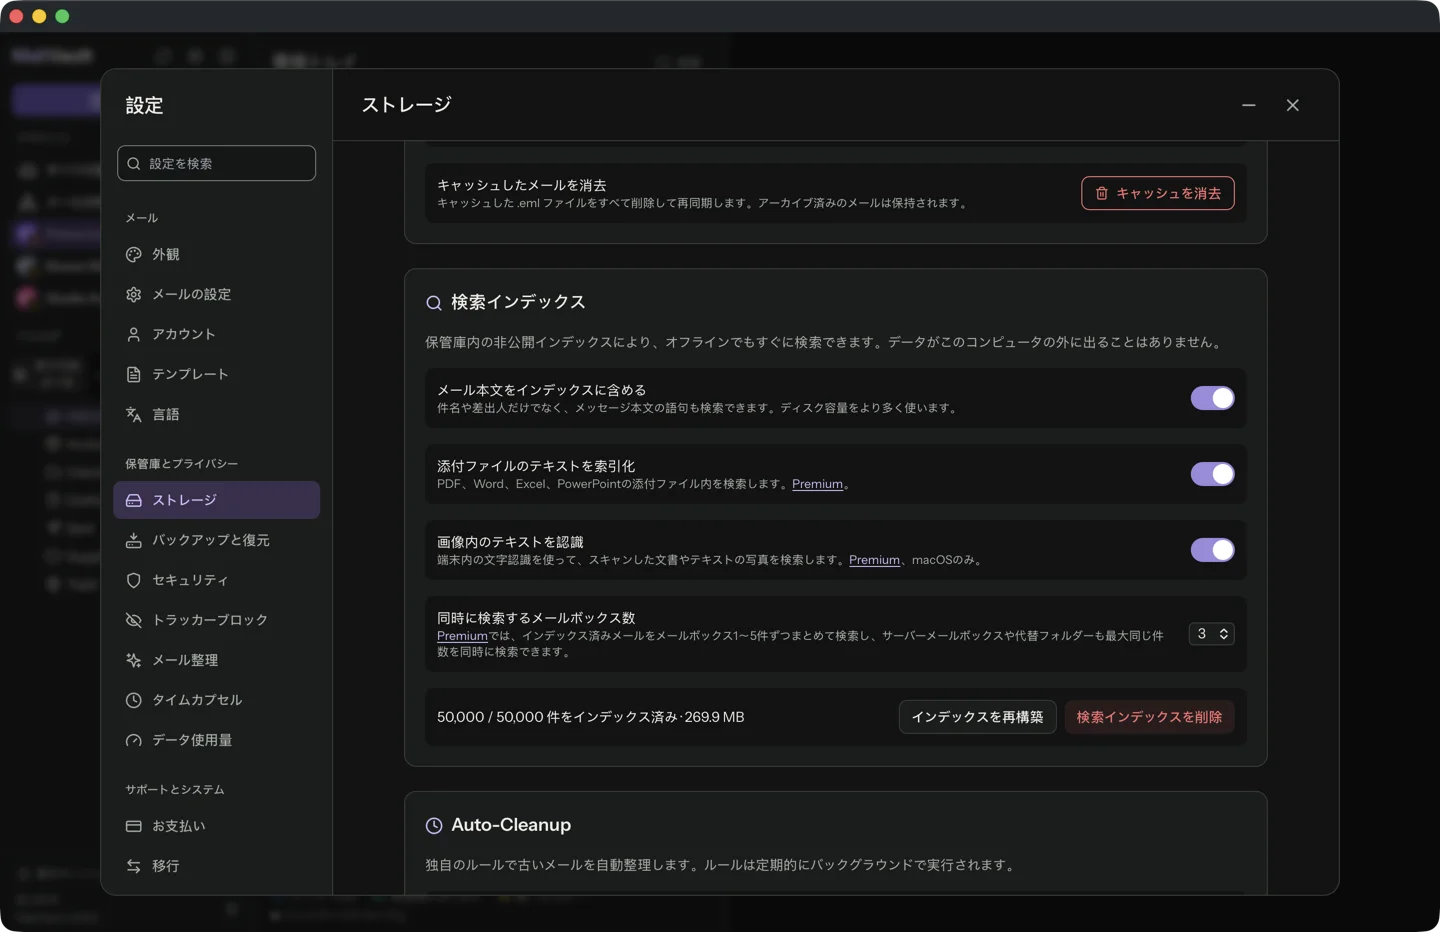
その条件を満たすのが、FTS5 全文検索モジュールを備えた SQLite です。ファイルは 1 つで、1 つのプロセスが開き、先行書き込みログモードと排他ロックで動かします。保管庫がネットワーク共有上にあることもあるため、この構成にしました。テキストは 2 つの仮想テーブルが保持します。
- ラテン文字のテキスト用の trigram テーブル。 すべての単語が、重なり合う 3 文字の断片として保存されるため、
voicと入力するとinvoiceが見つかります。ワイルドカード構文も、単語全体の一致という規則もありません。ダイアクリティカルマークは正規化されるため、reunionと入力するとRéunionが見つかります。1 文字や 2 文字のクエリは trigram より短いので、件名と差出人に対する単純な部分文字列の一致にフォールバックします。 - CJK 用の 2 つ目のテーブル。 日本語と中国語には区切りに使えるスペースがなく、単語も 2 文字であることが多くて trigram より短いため、1 文字ずつに分割し、それらをフレーズとして照合するトークナイザーを通します。これがなければ、
会議を検索しても何も見つかりません。
どちらのテーブルも contentless です。検索用の構造だけを保持し、メールの 2 つ目のコピーは持ちません。50,000 通が 225 MB に収まる大きな理由のひとつです。
検索はメッセージを開かない
一覧には、ヒットごとに差出人、件名、日付、フォルダー、フラグが必要です。それらを得るために 500 個のメッセージファイルを解析すると、クエリそのものより高くつきます。そこでインデックスの行には、すでに組み立て済みの一覧の行を保存し、現在のフラグは maildir 形式がフラグを保持しているファイル名から読み取ります。ベンチマークは、結果を組み立てる間の MIME パーサーの呼び出し回数を数えており、答えはゼロです。
メッセージを開くのはクリックしたときだけで、そのときにインデックスが記録した Message-ID と照合されるため、サーバーが再発行した UID によって別のメールが表示されることはありません。
インデックスを正直に保つ
保管庫とずれたインデックスは、ないより悪いものです。「削除したらインデックスも更新する」というフックを長く連ねることはしません。1 つのリコンサイラーが、フォルダーの一覧(uid、ファイル名、サイズ、更新日時)とインデックスの内容を比較し、差分を修復します。書き込む側はそれを促すだけです。ファイルが壊れているか、新しいスキーマのものであれば、削除してメールから作り直し、復旧コードが削除するのは派生データであるインデックスの 4 つのファイルだけです。メッセージ、カストディ記録、アカウントには一切触れません。
最初のバージョンがしていたこと
最初のオフライン検索はファイルを読んでいました。検索のたびにフォルダーを一覧し、各メッセージを UID で引くたびにディレクトリを新たにスキャンし、解析し、すべての本文をプロセス境界越しにシリアライズして、JavaScript で絞り込んでいました。その一部を測ったところ、ディレクトリの再スキャンは 20,000 通のフォルダーで約 4.4 ms かかり、それがメッセージごとに 1 回実行されるので、そのフォルダーだけでおよそ 88 秒になる計算です。これがインデックスの存在する理由であり、ファイルを開かない検索は最適化ではなく設計上の制約である理由です。
出荷してしまった速度低下
この記事のための数値を準備している間に、ベンチマークが失敗しました。2.15.0 リリースを含むコードでは、「invoice」に 221 ms、「budget meeting」に 500 ms かかり、テスト自身の 200 ms のアサーションが 3 回の実行すべてで失敗しました。9 月 13 日には、同じクエリの検索ステップは 4〜7 ms と測定されていました。
原因は、良い機能を不注意に加えたことでした。リーダーで一致した語句を強調表示し、添付ファイルの中だけで見つかったヒットに印を付けるため、各結果行に 2 つの問いを持たせました。本文は一致するか、添付ファイルのテキストは一致するか、です。それぞれを、全文検索テーブルに 1 行ずつ問い合わせるサブクエリとして書いたのですが、このような相関サブクエリは、問い合わせる行ごとに再実行されます。実行のたびにその語のポスティングをたどり直すので、コストはクエリの語によって変わります。246 件ヒットした 2 語のフレーズ(500 ms)は、約 2,500 件ヒットした 1 語(221 ms)より遅くなりました。
修正は、形を 1 行変えるだけです。一致する行の集合をインデックスに 1 回だけ問い合わせ、その集合に含まれるかどうかを調べます。結果は同じで、既存の 18 件のクエリテストは変更なし、新しいガードテストが 1 件加わり、4 つの数値は 7.4、14.0、14.0、4.5 ms に下がりました。教訓は退屈なものです。200 ms のゲートは存在していましたが、50,000 通のメッセージを作るのに 20 秒かかるため、ignore が付いていました。誰も実行しないゲートはドキュメントにすぎないので、この修正には通常のテスト実行で走るガードを付けて出荷します。
添付ファイルと Vision、Premium の側面
本文は無料です。添付ファイルのテキストは Premium のオプションで、同じインデックスに 1 つの列として加わるため、検索はメッセージとその中の文書を一緒にヒットさせます。
- Office ファイル (Word、Excel、PowerPoint)は XML を zip にまとめたもので、すべてのプラットフォームで純粋な Rust で読み取られます。
- PDF はテキストレイヤーを使います。macOS では PDFKit、それ以外では別の
pdf-extractプロセスを使います。 - 画像とスキャンした PDF は macOS ではデバイス上で Apple の Vision フレームワークを通し、1 文書あたり 50 ページを上限とします。小さな画像(10 KB 未満、または短辺が 128 ピクセル未満)は、読み取れる文字を含むには小さすぎるためスキップされます。Windows と Linux には OCR の工程はありません。
上限は意図的なものです。1 パートあたり 25 MB、アーカイブは展開後 50 MB までで、読み取れないファイルは記録された状態になり、再試行のループにはなりません。I/O エラーのような一時的な失敗は次回のスイープで再試行され、本当に未対応のファイルは、延々と試されないよう印が付けられます。この記事のために抽出時間は測っていません。抽出は添付ファイルごとに 1 回、バックグラウンドで実行され、そのコストはファイル次第です。
他のクライアントは自分たちの検索をどう説明しているか
他のクライアントは 1 つもベンチマークしておらず、どれも 50,000 通での検索時間を公表していません。したがって、これはストップウォッチではなく設計の比較です。Apple は 次のように述べています 。Spotlight の最初のインデックス作成には数時間、場合によっては数日かかることがあります。Microsoft は 次のように記しています 。クラシック版 Outlook の検索は Windows Search のインデックスに依存していること、それが完了するまで結果が不完全になりうること、インデックスされるのはキャッシュされたメールだけであることです。Thunderbird のトラッカーには、16 年前に起票された 報告 があり、大きなメールボックスでグローバルインデックスの作成が遅くなるという内容で、あるユーザーはデュアルコアのマシンで 36,000 通に数日かかったと書いています。これは個人の体験談で、しかも古いハードウェアの話なので、私たちの結果とは比較しません。
この結果でわからないこと
メールは人工的で短いものです。実際のメッセージはもっと長く、インデックスは本文のテキストとともに大きくなります。すべて 1 台の Mac でのウォームキャッシュでした。添付ファイルの検索は測っていません。サーバーにしかないメールは、そもそもインデックスに入っていません。MailVault はサーバーに問い合わせ、ローカルのヒットを先に表示し、その部分はプロバイダーに左右されるため、ここに数値はありません。Premium では、サーバーのメールボックスを 1 つではなく最大 5 つまで同時に検索できます。
5 万通のメール、ひと拍の間に。 MailVault はアーカイブのそばにプライベートな検索インデックスを持ちます。本文は無料、添付ファイルとデバイス上での画像テキストは Premium で利用できます。
MailVault を入手 →