A maioria dos clientes de e-mail trata a pesquisa como um recurso. Nós a tratamos como um orçamento de latência. A razão de existir do MailVault é você guardar décadas de e-mail no seu próprio disco, e um arquivo que você não consegue pesquisar em menos de um batimento cardíaco é um lixão.
Então montamos um cofre de 50.000 mensagens e o cronometramos. A consulta mais lenta levou 14 milissegundos. O interessante é o que foi preciso para chegar lá, e a versão em que a deixamos 30 vezes mais lenta sem perceber.
Os números
Uma máquina, cinco formatos de consulta, seis execuções cada (três em uma build de teste da correção, três no código já integrado). Os tempos são a pesquisa mais a montagem das linhas que a lista desenha:
MailVault daemon · release build · Apple M4, 16 GB · warm cache
50,000 synthetic messages, avg 3,334 bytes, 3 folders

query                    matches   rows    time (6 runs)
invoice                  ~2,500    500     7.1 – 7.5 ms
budget meeting           246       246     13.4 – 14.1 ms
update 4999              15        15      13.5 – 14.0 ms
会議                    1,529     500     4.3 – 4.6 ms
last 7 days, no words    1,008     500     1.0 ms

index build (cold)       50,000 msgs   10.9 – 11.9 s
index on disk            224,968,704 bytes
result-row parses        0
O corpus é gerado, não é e-mail real: 200 palavras de enchimento por mensagem em texto simples e em HTML, mais dez palavras plantadas em taxas fixas (invoice 5%, budget 8%, meeting 6%, entre elas três termos em japonês e com acentos), de modo que toda consulta tenha um tamanho de resposta conhecido. O gerador é determinístico, então uma nova execução constrói os mesmos 50.000 arquivos. A máquina foi compartilhada com outras builds enquanto os testes rodavam, então isto é um computador ocupado, não um laboratório.
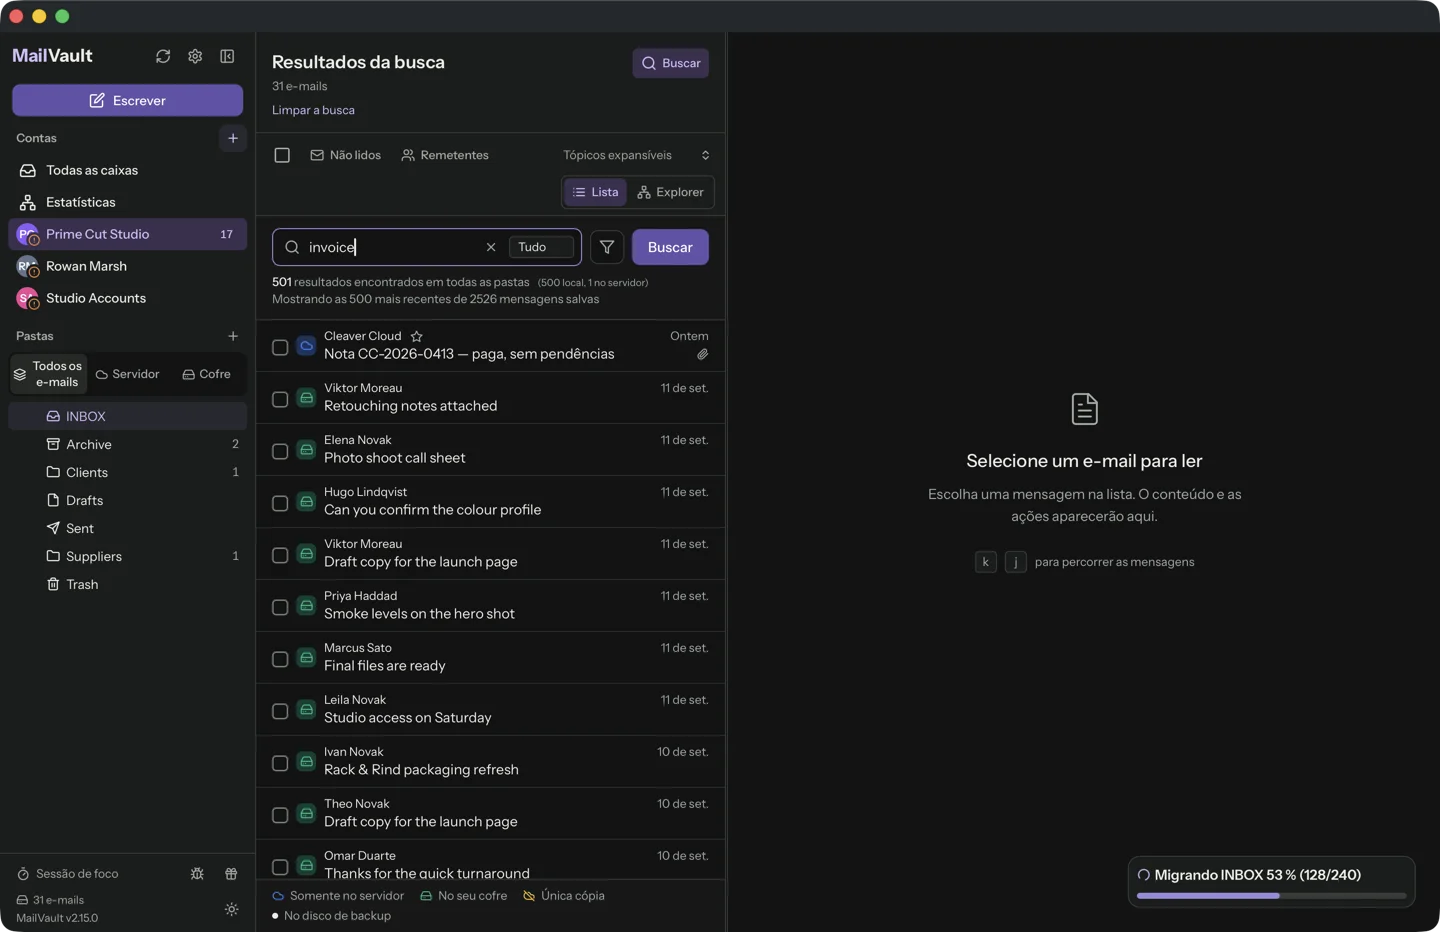
Para dar concretude à escala: uma tela de 60 Hz se redesenha a cada 16.7 ms, e toda consulta acima termina dentro de um redesenho. Os limites de resposta de Jakob Nielsen, inalterados desde 1993, são 0.1 s para “instantâneo”, 1 s para pensamento ininterrupto e 10 s para atenção perdida. Nossa resposta mais lenta é um sétimo do primeiro limite. A régua abaixo é logarítmica, cada marca dez vezes a anterior, e sua extremidade direita é onde vivia a primeira versão da pesquisa offline.
Confira você mesmo
O benchmark é um teste ignorado na árvore de código-fonte, então nunca deixa as execuções comuns mais lentas. Ele constrói o corpus em um diretório temporário, o indexa com o analisador MIME real e imprime cada linha acima:
cargo test -p mailvault-daemon --release \
  search_index_bench_50k_real_parser -- --ignored --nocapture
O corpus é escrito em um diretório novo logo antes de as consultas rodarem, então o cache de páginas está aquecido. A primeira pesquisa depois de uma reinicialização lê mais do disco. Não medimos esse caso e não afirmamos nada sobre ele.
Por que um banco de dados SQL simples, e não um mecanismo de busca
Os requisitos eram nada glamourosos. O índice tem que ficar dentro do cofre, porque o cofre pode ser movido para uma unidade externa ou para um ponto de montagem de NAS. Tem que funcionar offline. Tem que ser um dado derivado, que possamos descartar e reconstruir. E não pode acrescentar um serviço para iniciar, atualizar ou explicar a um usuário.
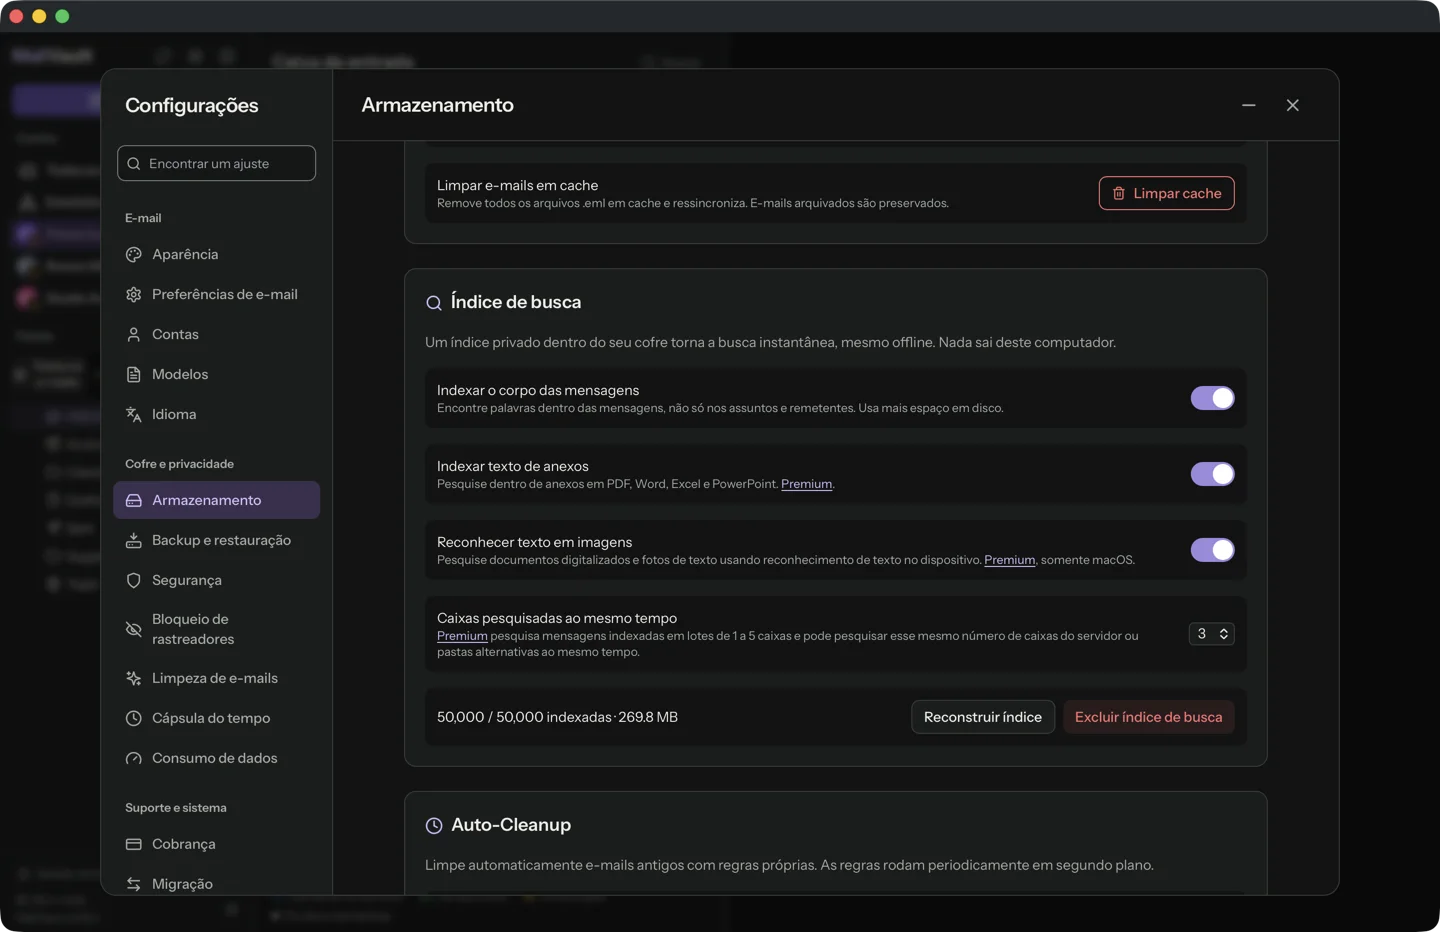
Isso é o SQLite com o módulo de texto completo FTS5. Um arquivo, aberto por um processo, em modo write-ahead-log com bloqueio exclusivo, escolhido porque o cofre pode ficar em um compartilhamento de rede. Duas tabelas virtuais carregam o texto:
- Uma tabela trigram para texto em alfabeto latino. Toda palavra é armazenada como pedaços sobrepostos de três letras, então
voicencontrainvoice, sem sintaxe de curinga e sem regra de palavra inteira. Os diacríticos são ignorados na comparação, entãoreunionencontraRéunion. Consultas de uma e de duas letras são mais curtas que um trigram, então recorrem a uma correspondência simples de substring no assunto e no remetente. - Uma segunda tabela para CJK. Japonês e chinês não têm espaços para dividir e suas palavras costumam ter dois caracteres, mais curtas que um trigram, então passam por um tokenizador que as divide em caracteres únicos e os casa como uma frase. Sem ele, uma pesquisa por
会議não encontra nada.
Ambas as tabelas são contentless: guardam as estruturas de pesquisa e não uma segunda cópia do seu e-mail, o que explica em boa parte por que 50.000 mensagens cabem em 225 MB.
A pesquisa nunca abre uma mensagem
A lista precisa de remetente, assunto, data, pasta e marcadores para cada resultado. Analisar 500 arquivos de mensagem para obtê-los custaria mais que a consulta. Então a linha do índice guarda a linha da lista já montada, e os marcadores atuais são lidos do nome do arquivo, onde o formato maildir os mantém. O benchmark conta as chamadas ao analisador MIME enquanto os resultados são montados, e a resposta é zero.
A mensagem só é aberta quando você clica nela, e então é conferida com o Message-ID que o índice registrou, de modo que um UID reemitido por um servidor não pode mostrar o e-mail errado.
Mantendo o índice honesto
Um índice que se afasta do cofre é pior que nenhum. Não há uma longa cadeia de ganchos do tipo “ao apagar, atualize também o índice”. Um único reconciliador compara a listagem da pasta (uid, nome do arquivo, tamanho, data de modificação) com o que o índice guarda e corrige a diferença. Todo escritor apenas o aciona. Se o arquivo estiver danificado ou for de um esquema mais novo, ele é apagado e reconstruído a partir do e-mail, e o código de recuperação só remove os quatro arquivos derivados do índice. Mensagens, registros de custódia e contas nunca são tocados.
O que a primeira versão fazia no lugar
A primeira pesquisa offline lia arquivos. Cada pesquisa listava a pasta, procurava cada mensagem por UID com uma nova varredura de diretório, a analisava, serializava cada corpo através da fronteira do processo e filtrava em JavaScript. Medimos uma parte disso: uma nova varredura de diretório custa cerca de 4.4 ms em uma pasta de 20.000 mensagens, e ela rodava uma vez por mensagem, o que projeta cerca de 88 segundos só para essa pasta. É por isso que o índice existe, e por que uma pesquisa que não abre nenhum arquivo é a restrição de projeto, e não uma otimização.
A lentidão que lançamos
Ao preparar os números para esta nota, o benchmark falhou. No código que inclui o lançamento 2.15.0, “invoice” levou 221 ms, “budget meeting” 500 ms, e a própria asserção de 200 ms do teste disparou nas três execuções. Em 13 de setembro, a etapa de pesquisa da mesma consulta tinha medido de 4 a 7 ms.
A causa foi um bom recurso acrescentado sem cuidado. Para destacar os termos encontrados no leitor e marcar os resultados achados só dentro de um anexo, cada linha de resultado ganhou duas perguntas: o corpo corresponde, o texto do anexo corresponde. Cada uma foi escrita como uma subconsulta que pergunta à tabela de texto completo sobre uma linha por vez, e uma subconsulta correlacionada assim é reexecutada para cada linha sobre a qual é perguntada. Cada execução percorre de novo as listas de ocorrências do termo, então o preço depende dos termos da consulta: uma frase de duas palavras com 246 resultados (500 ms) foi mais lenta que uma única palavra com cerca de 2.500 (221 ms).
A correção é uma mudança de forma de uma linha: perguntar ao índice uma vez pelo conjunto de linhas correspondentes e testar a pertinência a ele. Mesmos resultados, todos os 18 testes de consulta existentes inalterados e um novo teste de proteção, e os quatro números caíram para 7.4, 14.0, 14.0 e 4.5 ms. A lição é a entediante. O limite de 200 ms existia e estava marcado como ignorado, porque construir 50.000 mensagens leva vinte segundos. Um limite que ninguém verifica é documentação, então a correção vem com uma proteção que roda nas execuções de teste comuns.
Anexos e Vision, a metade Premium
Os corpos são gratuitos. O texto de anexos é uma opção Premium e se conecta ao mesmo índice como mais uma coluna, então uma pesquisa encontra as mensagens e os documentos dentro delas juntos.
- Arquivos do Office (Word, Excel, PowerPoint) são arquivos zip de XML e são lidos em Rust puro em todas as plataformas.
- PDFs usam a camada de texto: PDFKit no macOS, um processo
pdf-extractseparado nos demais sistemas. - Imagens e PDFs digitalizados passam pelo framework Vision da Apple no macOS, no próprio dispositivo, com limite de 50 páginas por documento. Imagens pequenas (menos de 10 KB ou 128 pixels no lado menor) são ignoradas por serem pequenas demais para conter texto legível. Windows e Linux não têm etapa de OCR.
Os limites são deliberados: 25 MB por parte, 50 MB descompactados para um arquivo compactado, e um arquivo ilegível vira um estado registrado, nunca um laço de novas tentativas. Uma falha transitória, como um erro de E/S, é tentada de novo na próxima varredura, e um arquivo realmente não suportado é marcado para não ser tentado para sempre. Não cronometramos a extração para esta nota. Ela roda uma vez por anexo em segundo plano, e seu custo depende dos seus arquivos.
O que os outros dizem sobre os deles
Não fizemos benchmark de nenhum deles, e nenhum publica tempos com 50.000 mensagens, então isto são projetos e não cronômetros. A Apple diz que a primeira indexação do Spotlight pode levar horas ou até dias. A Microsoft documenta que a pesquisa do Outlook clássico depende do índice do Windows Search, que os resultados podem ficar incompletos até ele terminar e que só o e-mail em cache é indexado. O rastreador do Thunderbird tem um relato de dezesseis anos sobre a indexação global ficando lenta em caixas de correio grandes, com um usuário citando vários dias para 36.000 mensagens em uma máquina de dois núcleos. É um caso anedótico em hardware antigo, e não o compararíamos com o nosso.
O que isto não mostra
O e-mail é sintético e curto, as mensagens reais são mais longas e o índice cresce com o texto dos corpos. Tudo foi com cache aquecido em um único Mac. A pesquisa em anexos não foi cronometrada. O e-mail que só existe no servidor não está no índice: o MailVault consulta o servidor, lista primeiro os resultados locais, e essa etapa é limitada pelo provedor, então não tem número aqui. O Premium pesquisa até cinco caixas do servidor ao mesmo tempo, em vez de uma.
Cinquenta mil e-mails, um batimento cardíaco. O MailVault mantém um índice de pesquisa privado ao lado do seu arquivo: corpos de graça, anexos e texto de imagens no próprio dispositivo com o Premium.
Baixar o MailVault →