大多数邮件客户端把搜索当作一项功能。我们把它当作一份延迟预算。MailVault 存在的全部理由,就是让你把几十年的邮件留在自己的磁盘上,而一个无法在一次心跳之内完成搜索的归档,只是一堆垃圾。
所以我们构建了一个 50,000 封邮件的保险库并为它计时。最慢的查询用了 14 毫秒。有意思的是为此付出的努力,以及那个我们在没有察觉的情况下让它慢了 30 倍的发布版本。
数字
一台机器,五种查询形态,每种运行六次(三次在修复版的临时构建上,三次在合并后的代码上)。耗时包含搜索本身,以及组装列表所绘制的行:
MailVault daemon · release build · Apple M4, 16 GB · warm cache
50,000 synthetic messages, avg 3,334 bytes, 3 folders

query                    matches   rows    time (6 runs)
invoice                  ~2,500    500     7.1 – 7.5 ms
budget meeting           246       246     13.4 – 14.1 ms
update 4999              15        15      13.5 – 14.0 ms
会議                    1,529     500     4.3 – 4.6 ms
last 7 days, no words    1,008     500     1.0 ms

index build (cold)       50,000 msgs   10.9 – 11.9 s
index on disk            224,968,704 bytes
result-row parses        0
语料是生成的,不是真实邮件:每封邮件有 200 个填充词,分纯文本和 HTML 两种,再加上十个按固定比例植入的词(invoice 5%、budget 8%、meeting 6%,其中包括三个日语和带重音的词),这样每个查询的结果规模都是已知的。生成器是确定性的,所以重新运行会构建出同样的 50,000 个文件。测试运行期间这台机器还在与其他构建共用,因此这是一台忙碌的电脑,而不是实验室。
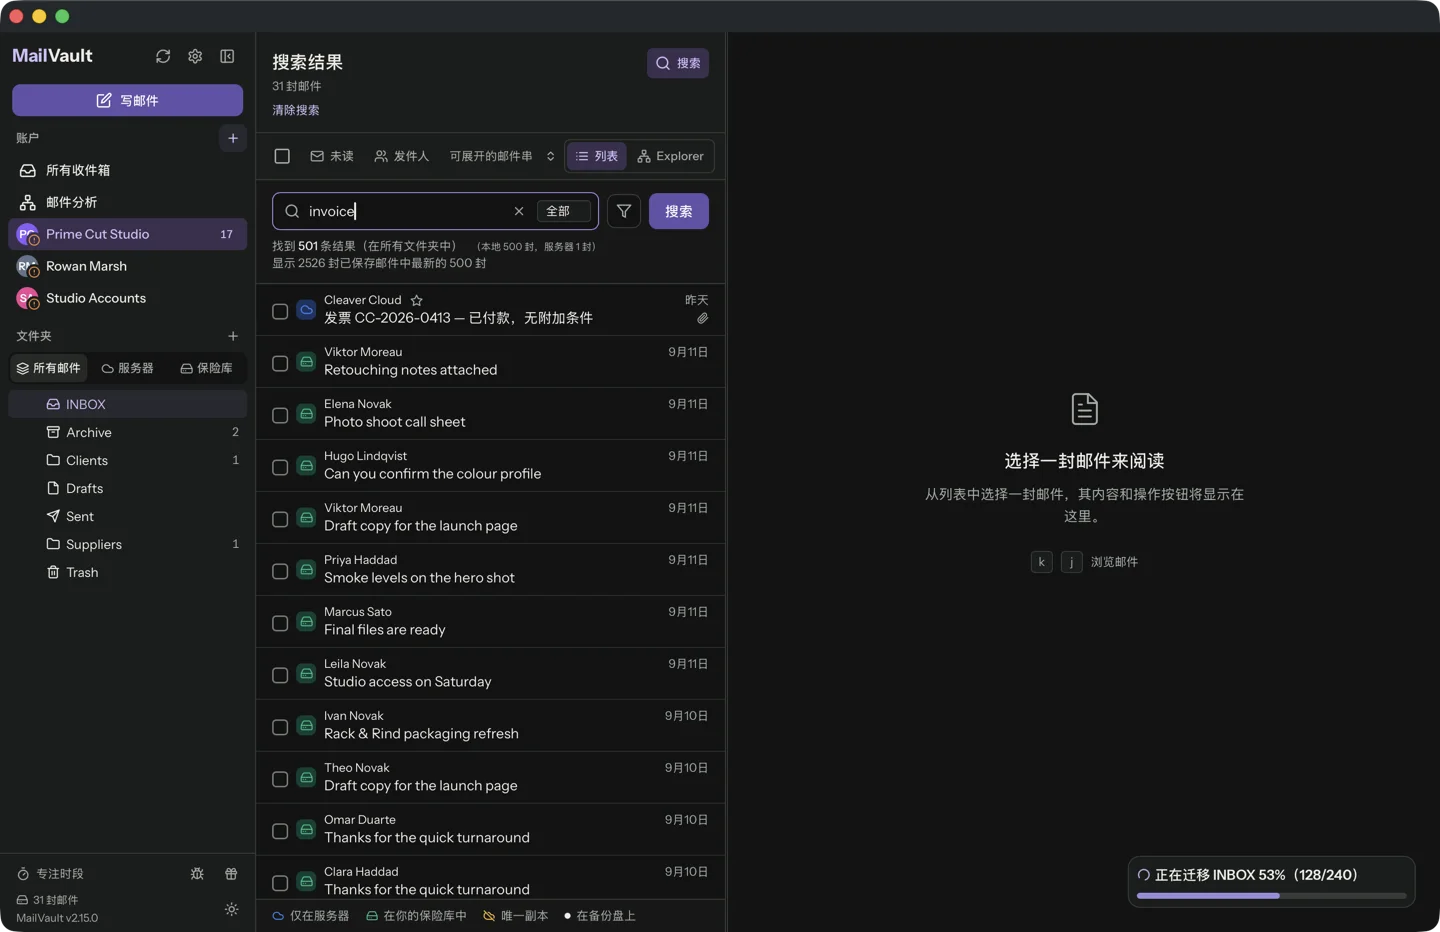
为了让尺度更具体:60 Hz 的显示器每 16.7 ms 重绘一次,而上面每个查询都在一次重绘之内完成。Jakob Nielsen 的响应时间界限自 1993 年以来从未改变:0.1 s 是“瞬时”,1 s 是思路不被打断,10 s 则是注意力流失。我们最慢的答案只有第一个界限的七分之一。下面的标尺是对数刻度,每一格是前一格的十倍,它的右端就是离线搜索第一个版本所在的位置。
自己动手验证
这个基准测试是源码树中一个被忽略的测试,所以不会拖慢日常运行。它在临时目录里构建语料,用真实的 MIME 解析器为其建立索引,并打印上面的每一行:
cargo test -p mailvault-daemon --release \
  search_index_bench_50k_real_parser -- --ignored --nocapture
语料在查询运行前才写入一个全新的目录,所以页面缓存是热的。重启后的第一次搜索会从磁盘读取更多内容。我们没有测量过这种情况,也不对此作任何声明。
为什么用朴素的 SQL 数据库,而不是搜索引擎
需求并不光鲜。索引必须放在保险库内部,因为保险库可以被移到外部驱动器或 NAS 挂载点上。它必须能离线工作。它必须是可以丢弃并重建的派生数据。而且它不能增加一个需要启动、打补丁或向用户解释的服务。
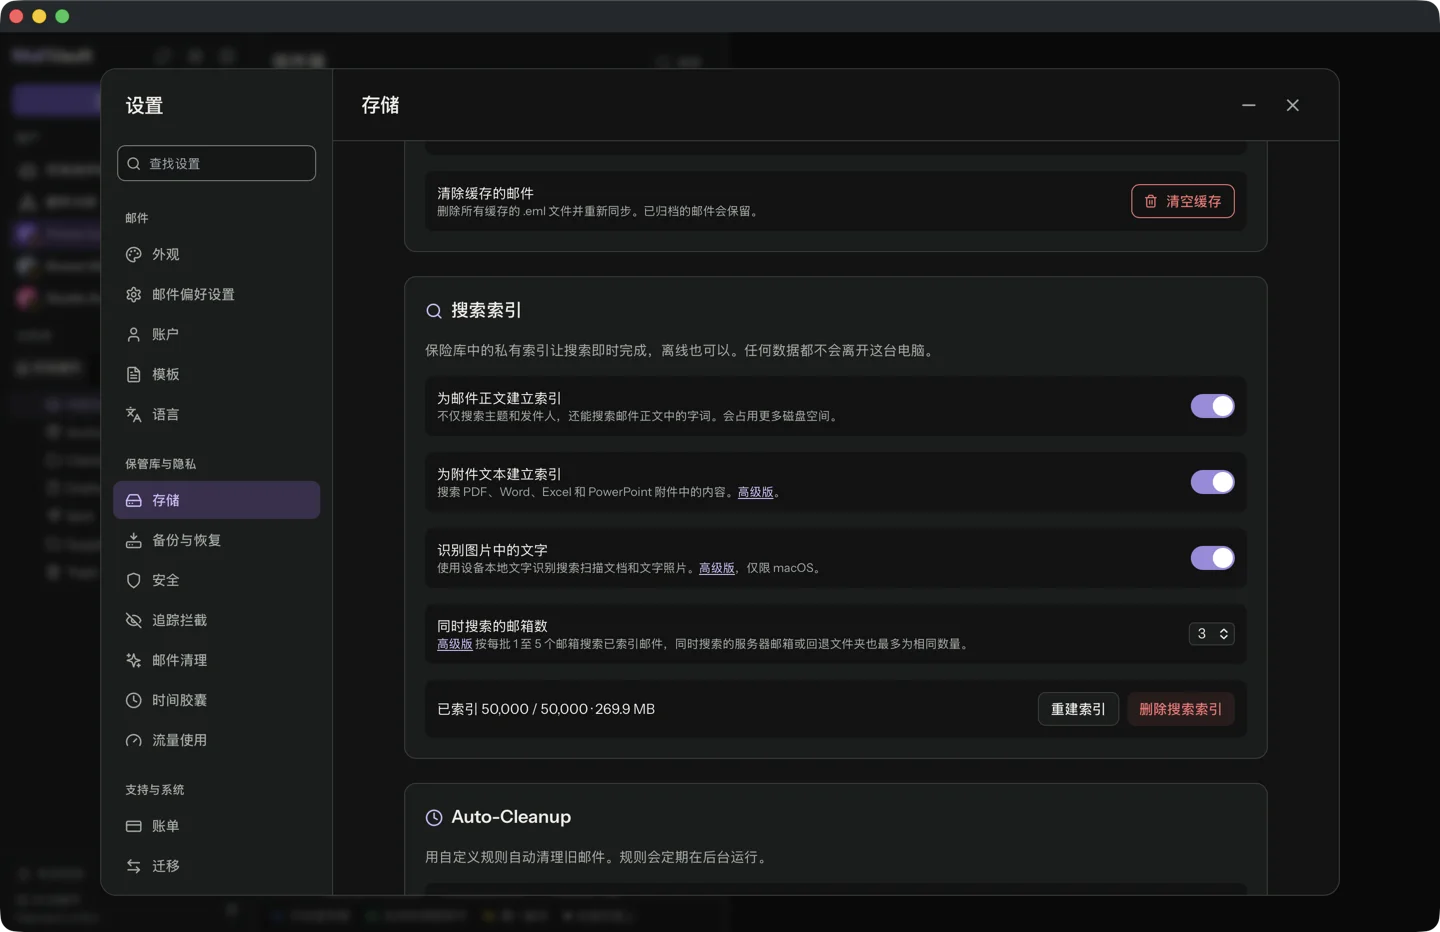
这就是带 FTS5 全文模块的 SQLite。一个文件,由一个进程打开,使用预写日志模式并加排他锁,之所以这样选择,是因为保险库可能位于网络共享上。两张虚拟表承载文本:
- 一张用于拉丁文字的 trigram 表。 每个词都会被存成相互重叠的三字母片段,因此
voic能找到invoice,无需通配符语法,也没有整词规则。变音符号会被折叠,所以reunion能找到Réunion。一个或两个字母的查询比一个 trigram 还短,所以它们会退回到对主题和发件人的普通子串匹配。 - 第二张表用于中日韩文字。 日语和中文没有可用来切分的空格,词又常常只有两个字,比一个 trigram 还短,所以它们会经过一个分词器,被拆成单个字符,再作为短语来匹配。没有它的话,搜索
会議什么也找不到。
两张表都是无内容表:它们只保存搜索结构,而不是你邮件的第二份副本,这在很大程度上解释了为什么 50,000 封邮件只占 225 MB。
搜索从不打开邮件
列表需要每条命中的发件人、主题、日期、文件夹和标记。为拿到这些而解析 500 个邮件文件,代价会比查询本身还高。所以索引行里直接存着已经构建好的列表行,而当前的标记则从文件名中读取,maildir 格式就把它们放在那里。基准测试会统计结果组装期间对 MIME 解析器的调用次数,答案是零。
只有当你点击邮件时才会打开它,并且会与索引记录的 Message-ID 进行核对,所以被服务器重新分配的 UID 不会让你看到错误的邮件。
让索引保持准确
与保险库脱节的索引比没有索引更糟。这里没有一长串“删除时同时更新索引”的钩子。由一个协调器把文件夹列表(uid、文件名、大小、修改时间)与索引中保存的内容进行比较,并修复差异。每个写入方都只是提醒它一下。如果文件已损坏,或来自更新的模式版本,它就会被删除并根据邮件重建,而恢复代码只会删除四个派生的索引文件。邮件、托管记录和账户从不会被触碰。
第一个版本原本是怎么做的
第一个离线搜索是读文件的。每次搜索都要列出文件夹,通过重新扫描目录按 UID 查找每封邮件,解析它,把每个正文跨进程边界序列化,再用 JavaScript 过滤。我们测量了其中一环:在 20,000 封邮件的文件夹上,一次目录重新扫描约需 4.4 ms,而它对每封邮件都要运行一次,仅这个文件夹就推算出约 88 秒。这就是索引存在的原因,也是为什么“不打开任何文件的搜索”是一项设计约束,而不是一种优化。
我们发布出去的性能下降
在为这篇笔记准备数字时,基准测试失败了。在包含 2.15.0 发布版本的代码上,“invoice”用了 221 ms,“budget meeting”用了 500 ms,测试自带的 200 ms 断言在三次运行中每次都被触发。而在 9 月 13 日,同一个查询的搜索步骤测得的是 4 到 7 ms。
原因是一个好功能被草率地加了进来。为了在阅读器中高亮匹配的词,并标记只在附件内部找到的命中,每个结果行都被附带了两个问题:正文是否匹配,附件文本是否匹配。每个问题都被写成一个子查询,一次只向全文表询问一行,而这样的相关子查询会为它被询问的每一行重新运行一遍。每次运行都会重新遍历该词的倒排列表,所以代价取决于查询词:有 246 条命中的两个词的短语(500 ms)比约有 2,500 条命中的单个词(221 ms)更慢。
修复只是改了一行的形态:向索引一次性询问匹配行的集合,然后检查成员关系。结果不变,现有的 18 个查询测试都没有改动,另外新增了一个守护测试,四个数字降到了 7.4、14.0、14.0 和 4.5 ms。教训很无聊:那道 200 ms 的门槛是存在的,但被标成了忽略,因为构建 50,000 封邮件要二十秒。没人运行的门槛只是文档,所以这次修复附带了一个会在日常测试中运行的守护测试。
附件和 Vision:Premium 的那一半
正文搜索是免费的。附件文本是 Premium 的选项,它作为多出来的一列接入同一个索引,所以一次搜索能同时命中邮件和其中的文档。
- Office 文件 (Word、Excel、PowerPoint)是由 XML 组成的 zip 压缩包,在所有平台上都用纯 Rust 读取。
- PDF 使用文本层:macOS 上用 PDFKit,其他平台用单独的
pdf-extract进程。 - 图片和扫描版 PDF 在 macOS 上通过 Apple 的 Vision 框架处理,在设备本地完成,每份文档最多 50 页。小图片(小于 10 KB,或短边不足 128 像素)会被跳过,因为太小,装不下可读的文字。Windows 和 Linux 没有 OCR 这一步。
限制是有意设定的:每个部分 25 MB,压缩包解压后 50 MB,而无法读取的文件会变成一个被记录下来的状态,绝不会变成重试循环。像 I/O 错误这样的暂时性失败会在下一轮扫描时重试,而确实不受支持的文件会被标记,这样就不会一直尝试。这篇笔记没有为提取计时。它在后台对每个附件运行一次,代价取决于你的文件。
其他产品如何描述它们自己的搜索
我们没有对其中任何一个做基准测试,它们也都没有公布 50,000 封邮件规模下的耗时,所以这里比较的是设计,而不是秒表读数。Apple 表示 Spotlight 首次建立索引可能需要数小时甚至数天。Microsoft 记载 经典版 Outlook 的搜索依赖 Windows Search 索引,索引完成前结果可能不完整,并且只有已缓存的邮件才会被编入索引。Thunderbird 的跟踪器里有一份已有十六年历史的 报告 ,反映大型邮箱上的全局索引会变慢,其中一位用户称在双核机器上为 36,000 封邮件用了好几天。这只是个例,且是旧硬件,我们不会拿它与我们的结果相比。
这次测试没有显示什么
邮件是合成的,而且很短,真实的邮件更长,索引会随正文文本增长。所有测试都是在一台 Mac 上、缓存已预热的情况下进行的。附件搜索没有计时。只存在于服务器上的邮件根本不在索引里:MailVault 会去询问服务器,先列出本地命中,而那一段受限于服务商,所以这里没有它的数字。Premium 可以一次搜索最多五个服务器邮箱,而不是一个。
五万封邮件,一次心跳。 MailVault 在你的归档旁边保存一个私有的搜索索引:正文搜索免费,附件和设备本地的图片文字搜索包含在 Premium 中。
获取 MailVault →